路径 A:分数进步了,为什么这一句仍然错
课堂接续:T15 · T16 · T17 · T33 · T34。连续读本:第2章:右移训练与生成 · 第3章:真实反转样本与搜索诊断;本主题提供独立定义、例子、代码与来源。
源句为“我昨天给了他一本书。”,选定译文为 I gave him a book yesterday .。当前给书主线的训练与生成可以先用同一张右移表分清:
生成的下一步输入来自刚刚选择的词;训练已有参考译文,可以为每个位置提供正确历史。右移对齐如下:
| 输入位置 | BOS | I | gave | him | a | book | yesterday | . |
|---|---|---|---|---|---|---|---|---|
| 本位置目标 | I | gave | him | a | book | yesterday | . | EOS |
在gave这一输入行预测him时,可用历史只有BOS、I、gave及完整中文源句。him作为标签用于求loss,不能先送入同一预测位置。这就是teacher forcing使用真实历史的含义;所有位置的误差汇总后,通过输出头、decoder、encoder与embedding更新共享参数。
训练与生成使用同一套条件概率模型,下一步历史的提供者不同。生成若选错一个词,后续条件会随之偏离真实历史;若第一个错误已经发生在两种前缀仍完全相同的位置,就不能将它归咎于更早的自馈错误。完整生成、EOS和任务评价仍须单独检查。
接下来切换到已经保存的六字符反转实验,完整保留原输入、标签、checkpoint、首错位置、beam与EOS。它不是自然语言给书句,也不因课堂改成他/him而改动任一字符或结果。路径A用这个具体失败区分评分、搜索与自馈条件。
阅读本主题 · 返回实验 · 与Agent共读全文
读本: CLS 03 · 生成、视觉条件与上下文 ,查找“路径 A:分数进步了,为什么这一句仍然错”;实验中查找“路径A · 分数进步了,为什么这一句仍然错”。
一条已经失败的序列
这里切换到已经训练的合成序列反转任务。它不是her/him教学翻译;源序列、正确目标、实际输出与checkpoint身份在下表列出。动态组300条整句中仍有39条失败。构造翻译里正确候选得分更高却未返回,支持查搜索;当前真实样本将检验另一种排序情形。
| 对象 | 固定选择后的实际内容 |
|---|---|
| 源序列 | b d a d e |
| 应得(含结束符) | e d a d b <EOS> |
| greedy实际输出 | d e d a b <EOS> |
| 第一次分歧(从1计) | 1 |
这里使用DN1在Deepnote训练并保存的 dynamic-500.pt。按存档test顺序取第一条greedy失败的样本,得到从0计的索引25;没有为了让beam修好错误而另挑样本。DN2普通CPU只读重算,把同一对象的teacher forcing、自由生成与beam接起来。
训练/验证/测试3000/300/300,源长3–7,各集合源序列不重复。两组共享BiLSTM encoder与LSTM decoder设计、共同500次更新、各102417训练目标token;固定摘要15577参数,动态读取16601,多1024个query投影参数。没有多种子置信区间。
真实翻译也有条件输入、前缀和搜索,但可能存在多个合格译文、歧义、未知实体与复杂对齐;这里exact match的唯一目标不能替代翻译评价,更不能解释旧六片段诊断句“她→他”的全部原因。当前结果只支持这个受控合成任务上的比较。
同一格里,训练和生成看见什么
Teacher forcing:每步接入正确的历史。
| 步 | 真前缀 | 目标 | p(目标) | argmax |
|---|---|---|---|---|
| 1 | <BOS> | e | 0.327242 | d |
| 2 | <BOS> e | d | 0.990110 | d |
| 3 | <BOS> e d | a | 0.914952 | a |
| 4 | <BOS> e d a | d | 0.992090 | d |
| 5 | <BOS> e d a d | b | 0.982063 | b |
| 6 | <BOS> e d a d b | <EOS> | 0.962593 | <EOS> |
自由生成:每步接入自己已经选出的词。按同一步号对照上表,最后一列仍查询标准目标,而非所选词的概率。
| 步 | 自馈前缀 | 选词 | p(同位置标准目标) |
|---|---|---|---|
| 1 | <BOS> | d | 0.327242 |
| 2 | <BOS> d | e | 0.000236 |
| 3 | <BOS> d e | d | 0.134230 |
| 4 | <BOS> d e d | a | 0.001531 |
| 5 | <BOS> d e d a | b | 0.997601 |
| 6 | <BOS> d e d a b | <EOS> | 0.855428 |
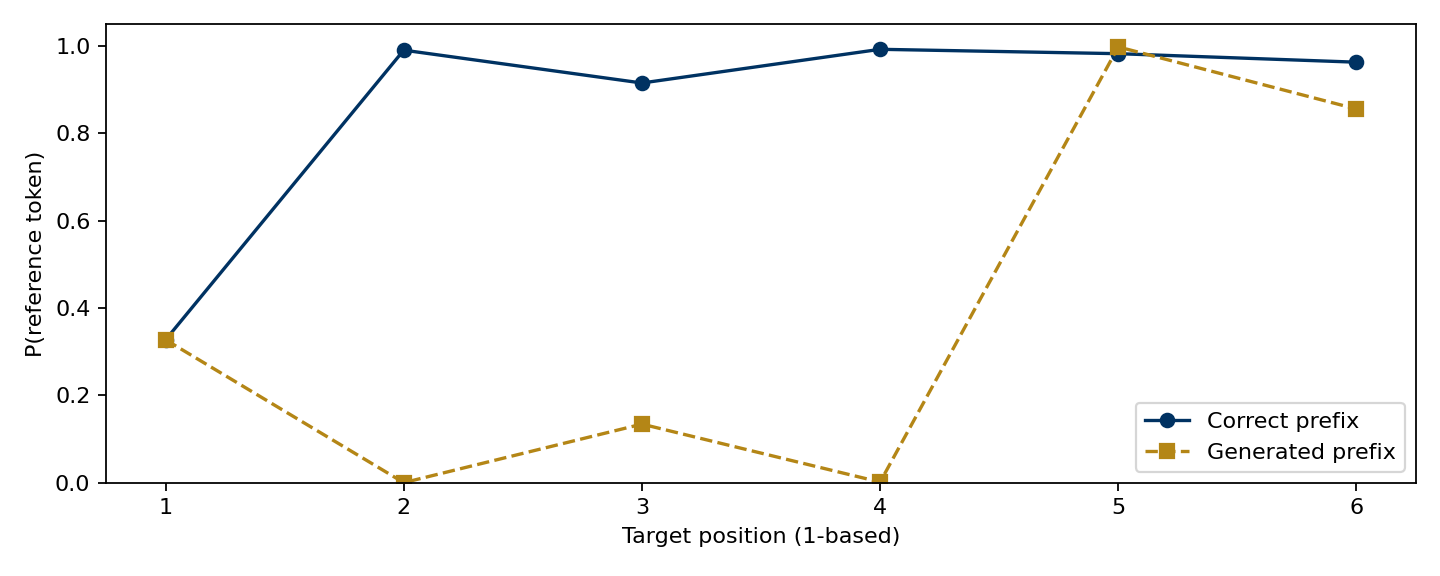
图中横轴是目标位置;两线都取该位置标准目标的概率,条件前缀分别来自标准答案与实际生成,曲线不是两次新训练。
第一次分歧发生在第1步,此时两种路径都还只有BOS作为decoder输入,所以不能把第一步错误归因于先前自馈错误积累。模型已给d比正确e更高的概率。第2步开始,teacher forcing接回正确e,自由生成接回自己选出的d,两个条件分布不再相同。此后出现错位,并不能只靠观察一句输出判定是状态信息不足、读取错位还是前缀分布变化。
在这个实现中动态读取的初始h为0,query投影无bias,第一步对所有有效源位置均匀读取;encoder状态仍可能携带足够信息,所以“均匀”本身不等于必然失败。它提出一个可检验假设:初始化/读取时序可能影响首词。另一个解释是当前模型对这个排列训练不足。比较同长度样本的首词错误分布、检查首步表示,再做受控初始化训练,才能区分;这些初始化训练仍是待做对照。
指标变好没有承诺每一句都对
| 模型 | TF平均NLL | TF token正确率 | 自由生成exact match |
|---|---|---|---|
| fixed | 0.287898 | 90.9722% | 57.67% |
| dynamic | 0.106673 | 97.7679% | 87.00% |
NLL和token accuracy在正确前缀下按2016个有效目标token(含EOS、排除PAD)汇总;exact match在自由生成下按300条完整样本算。它们不是同一分母,也不是同一种输入条件。动态组总体更好,却仍有39条整句失败。这条样本让平均进步与局部失败同时变得具体:不需要用“attention更强”来掩盖错误。
正确答案的整句log概率可直接将teacher-forced各目标的log p相加;对候选句也用它自己的前缀逐步计分。它是概率模型的排序,不是教师对忠实性的判分。
beam有没有把正确答案漏掉
| 宽度 | 最高分完成序列 | 累计log p(含EOS) | exact match |
|---|---|---|---|
| 1 | d e d a b <EOS> | -0.905535 | False |
| 2 | d e d a b <EOS> | -0.905535 | False |
| 4 | d e d a b <EOS> | -0.905535 | False |
同一正确序列的teacher-forced累计log p = -1.280045。beam2最后一轮确实保留了这条正确完成项,仍把错误项排在前面。
beam2已经把正确序列保留到了结束,但它的分数低于错误序列,所以加宽到4仍选错。这个观察削弱“只是beam太窄漏掉正确路径”的解释;它没有证明已找到全词表所有可能句子的全局最优。它还表明在这条样本上,搜索更忠实地执行当前分数,不一定让任务更正确。可检查的是模型排序为何偏好错序,而不是继续机械增加beam。
表中数值是DN2本地CPU参考重算;Deepnote同一checkpoint的云端保存输出中,错误完成项为−0.905534469,本地为−0.905535110,相差约6.41×10⁻⁷。环境与浮点运算顺序会造成末位差别;样本、首错与候选排序一致,不能要求逐位相同。
旧扩展概率树是另一种身份:人为规定归一化边概率,用来展示局部选择与整句分数分离;不要把树上的A/B概率当成这次checkpoint输出。真实模型中EOS完成项占beam名额,累计log p含EOS、无长度惩罚;Sutskever原论文的完成集合管理不同,不宣称逐行复刻。
从这里提问,再回到同一个对象
你可以把本主题URL交给Agent,用自己的话描述:“它已经把正确顺序留在候选里了,为什么还选错?”上下文应包含这条源/目标、checkpoint身份和上述分数,而不是只贴87%。Agent能据正文区分搜索、概率和任务正确性;若讨论你的私人运行,需要你另附参数和输出。
回到LAB02的“路径A · 分数进步了,为什么这一句仍然错”,运行下面的只读检查;它重新按固定规则取样,不覆盖参考文件。把beam宽度改为已有1/2/4中的另一值,核对正确路径是否出现、它的累计分数与第一分歧。返回判断应是“这个checkpoint的这个样本不因当前beam加宽而修好”,不是“beam永远没用”或“所有错误都来自exposure bias”。
import learning_paths as paths
A = paths.path_a(ROOT)
print(A['test_index'], A['source'], A['target'], A['greedy'])
display(pd.DataFrame(A['teacher_forced']))
display(pd.DataFrame(A['free_trace']))
print({w:(x['tokens'], x['log_probability']) for w,x in A['beam'].items()})
beam_width = 2  # 可选1、2、4;结果对象的键是字符串
display(pd.DataFrame(A['beam'][str(beam_width)]['trace'][-1]))
复核与实现
| 复核项 | 身份 |
|---|---|
| 存档test索引(从0计) | 25 |
| checkpoint | dynamic-500.pt |
| SHA256 | 67ffebe93c8072e23b65a03b3ded8c6eabd18bff5701986f36747842d7634b38 |
| 结果身份 | DN2本地CPU只读重算;云端保存输出的末位差异见beam段 |
下面是与上述检查同源的诊断函数:包括固定取样、加载权重、两种前缀与beam。它读取参考文件;结果写入由LAB的独立输出目录管理。
@torch.no_grad()
def path_a(root):
    root=Path(root);p=root/'results/cloud/seq2seq'
    models,data,report=seq.load_pair(p)
    rows=data['test'];model=models['dynamic'];pred,_,_=seq.greedy(model,rows)
    # Rule fixed before inspecting the selected answer.
    idx=next(i for i,r in enumerate(rows) if pred[i]!=r['target']);row=rows[idx]
    src,l,di,y=seq.batch([row]);logits,_=model(src,l,di);lp=logits.log_softmax(-1)[0]
    free=pred[idx];first=next(i for i,(a,b) in enumerate(zip(free,row['target'])) if a!=b)
    z,mask=model.encode(src,l);state=model.initial(1);token=torch.tensor([seq.BOS]);trace=[];prefix=[]
    for t in range(max(12,len(row['target'])+2)):
        out,state,weights=model.step(token,state,z,mask);prob=out.softmax(-1)[0];chosen=int(prob.argmax())
        trace.append({'step_one_based':t+1,'input_prefix':[seq.VOCAB[seq.BOS]]+[seq.VOCAB[x] for x in prefix],
                      'chosen':seq.VOCAB[chosen],'p_chosen':float(prob[chosen]),
                      'p_reference_here':float(prob[row['target'][t]]) if t<len(row['target']) else None,
                      'reference':seq.VOCAB[row['target'][t]] if t<len(row['target']) else None,
                      'source_weights':weights[0].tolist()})
        prefix.append(chosen);token=torch.tensor([chosen])
        if chosen==seq.EOS:break
    tf=[{'step_one_based':t+1,'input_prefix':[seq.VOCAB[seq.BOS]]+[seq.VOCAB[x] for x in row['target'][:t]],
         'target':seq.VOCAB[tok],'argmax':seq.VOCAB[int(lp[t].argmax())],
         'p_target':float(lp[t,tok].exp()),'nll':float(-lp[t,tok])} for t,tok in enumerate(row['target'])]
    metrics={}
    for name,m in models.items():
        nll=correct=count=0
        for i in range(0,len(rows),32):
            s,ll,dd,yy=seq.batch(rows[i:i+32]);oo,_=m(s,ll,dd);valid=yy!=seq.PAD
            nll+=float(torch.nn.functional.cross_entropy(oo.flatten(0,1),yy.flatten(),ignore_index=seq.PAD,reduction='sum'))
            correct+=int(((oo.argmax(-1)==yy)&valid).sum());count+=int(valid.sum())
        pp,_,_=seq.greedy(m,rows)
        metrics[name]={'teacher_forced_nll':nll/count,'teacher_forced_token_accuracy':correct/count,
                       'free_generation_exact_match':sum(a==b['target'] for a,b in zip(pp,rows))/len(rows),'valid_tokens':count}
    return {'identity':'DN2 local CPU read-only reevaluation of DN1 cloud checkpoints; no retraining',
            'selection_rule':'first dynamic greedy failure in stored test order, zero-based index',
            'test_index':idx,'source':[seq.VOCAB[x] for x in row['source']],
            'target':[seq.VOCAB[x] for x in row['target']], 'greedy':[seq.VOCAB[x] for x in free],
            'first_divergence_one_based':first+1,'teacher_forced':tf,'free_trace':trace,
            'beam':{str(w):seq.beam(model,row,w) for w in [1,2,4]},'metrics':metrics,
            'config':model.config,'checkpoint_sha256':{n:hashlib.sha256((p/f'{n}-500.pt').read_bytes()).hexdigest() for n in models},
            'data_sha256':hashlib.sha256((p/'data.json').read_bytes()).hexdigest()}
来源:LAB02存档results/cloud/seq2seq的data.json与fixed/dynamic-500.pt;正文结果与哈希同源导出,完整JSON附在主题入口。训练背景见R7读本第二、三章与Seq2Seq2014 v1。模型诊断是DN2只读重算,历史57.67%/87.00%训练身份保留。
相邻知识与复核资源
全部主题 · 关键结果JSON · 只读诊断源码 · Seq2Seq完整实现 · 视觉机制实现 · TinyDecoder与cache实现