第一章 翻译要学什么:从关系与短语到共享表示
本章以“我昨天给了他一本书”为同一个对象,从实际翻译决定走进传统NLP的分析职责,再看字符、ID、one-hot、embedding与表示学习。旧计数语料、混排消息和历史错译作为独立扩展保留,均不替换主例。
1.1 从一句能听懂的话开始
同一件事可以有不止一种合适译法。“我昨天给了他一本书。”可以译为 I gave him a book yesterday.,也可以把时间放在开头:Yesterday, I gave him a book.。下面固定第一种,目的是沿同一对象追踪计算,不是把其他通顺译法判错。选择的目标序列为 I/gave/him/a/book/yesterday/./EOS。句号属于文本,EOS表示这一生成结束;BOS则是开始输入的约定。
词典替换能给出一个人为构造的教学草稿:I yesterday give he one book.。这不是任何翻译产品的实测输出,而且“了”和“本”还没有得到合理处理。草稿把一部分词义找到了,却没有解决接收者形式、事件时间、数量短语与语序。要补上这些决定,需要分析词在这一次表达中的作用。
1.2 分词、词性、结构与实体各回答什么
本讲选择九个单位 我/昨天/给/了/他/一/本/书/。。这套切分服务于解释;“给了”“一本”也可以在另一个切分系统中成组,不能把本课九格冒充某个真实 tokenizer 的唯一输出。词性分析问每个单位在这里属于什么类别:我、他是代词,给是动词,书是名词,昨天是时间表达,一是数词,本是量词,了在此分析中是助词,句号是标点。词性、句中角色与依存关系是不同层面的标签。
“本”不能只靠字形决定。“本书介绍……”中的本可表示“这本”;“一本书”中的本与数词一、名词书共同形成数量短语,承担量词作用。这次局部上下文已经足以区分两义。词典提供候选,语境帮助选择,不需要先声称必须理解整个人生故事才能确定每一个词。
角色分析则问谁做了什么:给出者是我,接收者是他,交付物是一本书,时间是昨天。简化成分树把整个句子展开为主语、时间和动词短语,再把动词短语中的动词、宾语成分和名词短语“一本书”分开。树中的“宾语成分”是句法标记,角色图中的“接收者”是语义角色,两者不混作同一类节点。括起“一本书”表示它在这里共同承担交付物,不等于“一、本、书”三个单位从此永远不可分。这是一棵为说明关系而选择的教学分析树,没有宣称来自实际 parser 或唯一标准答案。
实体抽取又是另一项任务。若 schema 只允许 PER / ORG / LOC,原句中的我和他不是具名的人名 span,昨天也不属于允许的三类;因此可以返回空集合。代词在语义上指向人,不意味着要标成 PER,更不能凭空补出书名。为了看清有名字时会怎样,另作明确赋值:这一次设“我=张明、他=李华”,把句子改写为“张明昨天给了李华一本书。”,才能在新句中返回 张明:PER、李华:PER。这不是从原句推断出的姓名。完成该独立示范后,翻译主线仍使用原句。
NER帮助系统定位和保留专名,却没有单独决定谁给谁;反过来,将我和他译成 I 和 him 也不要求知道其真实姓名。面向固定字段的字典、规则或学习式抽取器都可以有价值。它们要在同一文本、同一 schema、相同边界规则下比较误检与漏检;后文保留现代 GLiNER/GLiNER2 的完整证据,不能从一项受限任务推断所有小模型普遍更可靠。
回到实际翻译决定。接收者“他”在这里要用宾格 him;give 变成 gave 结合了昨天以及本句已完成的事件理解,不能推广为每一个“了”都必须译过去时。“一/本/书”可合成 a book,若语境特别强调数量,则 one book 也可能合适。英语把 yesterday 放到句末或句首都能保留时间;把中文位置原样照搬不是唯一选择。这里的结构分析帮助作出决定,但规则也要面对歧义、例外和新领域。
统计短语翻译进一步利用平行语料学习局部对应与重排,目标语言单语语料提供流畅性评分,搜索把候选组合起来。翻译特征、重排特征和语言模型可以共同评分;语言模型是其中一个组件,不能独自知道中文接收者是谁。传统统计方法已经从数据学习,神经方法的转折并不是第一次使用数据,而是让表示与计算更多共享。若“给他”“给她”和未见的新组合各自只有稀少计数,怎样把相邻经验用于新情况,就成为下一步的问题。
1.3 one-hot 只负责身份,embedding 的用途来自训练
设词表大小为 $V$,词 $w$ 的编号为 $i$。one-hot 向量 $e_i\in\mathbb R^V$ 只有第 $i$ 维为 1,其余为 0。两个不同词的点积都是 0;在这个表示里,“书”和“册”不会比“书”和“昨天”更接近。它没有错,只是尚未编码我们需要的相似关系。
令可学习的 embedding 表为 $E\in\mathbb R^{V\times d}$,按行存词向量,则
$$x_i=e_i^\top E=E_{i,:}\in\mathbb R^d.$$
查表与乘 one-hot 的数学结果相同,实际实现无需构造巨大的稀疏向量。$E$ 是参数;$x_i$ 是这次查表得到的激活。若一个批次出现了三次同一 token,三次计算会把梯度累加到同一行。训练不是给每次出现另存一套词向量,而是在任务损失的约束下共同修改这张表。
另设与当前九单位不混用的三项词表“我、她、书”,$d=2$,教学构造的表为 $E=[(1,0),(0,1),(1,1)]$。读到“书”取得 $(1,1)$,并不表示这两维天然叫“物品”和“知识”。向量轴通常没有预先指定的人类含义;重要的是网络后续能否利用它完成任务。对所有 embedding 进行某些可逆变换,并相应调整下游参数,模型甚至可能保持同样输出,所以不能把一幅二维散点图当作语义的唯一坐标系。
1.4 同一行参数,可以供许多上下文使用
同一个token ID每次查到同一行embedding;训练时不同出现位置的梯度共同修改这一行。于是“I gave”和“She gave”里共同的gave无需各自学习一份参数。后续网络还会利用本次输入中的其他词,形成不同的激活。查表提供共享起点,使用上下文才产生本次表示;这两个步骤必须分开。第四章先用同一给书句展开每个位置的读取,再保留bank两个语境的独立消歧说明。
对当前窗口,可以把各位置的embedding按顺序拼接,再用共享网络给下一词评分。它使相近上下文之间有机会共享统计,但不能创造没有进入输入的远处事实。
1.5 用邻近词制造训练样本:word2vec
先把“书”变成词表 ID,再查一张可学习表的对应行。ID只标身份;one-hot中两个不同单位的点积都是0,不会自动把书和册排得比书和昨天更近。Embedding行的数值由训练改变,维度并没有预先叫“知识”“物品”或“时间”。
在九单位句中,若窗口半径为1,以书为中心可得到“书→本”和“书→。”这样的中心—上下文训练对。Skip-gram为这两个角色保留两张独立参数表:中心表 $E_{\mathrm{in}}$ 的书行是 $v_{书}$,上下文表 $E_{\mathrm{out}}$ 的本行是 $u_{本}$;即使同一个词在两表中出现,也不是强制同一行数值。
| 表 | 索引对象 | 本次取得的向量 | 用途 |
|---|---|---|---|
| 中心表 $E_{\mathrm{in}}$ | 中心词ID:书 | $v_{书}$ | 表达本次中心 |
| 上下文表 $E_{\mathrm{out}}$ | 候选上下文ID:本及词表其他项 | $u_{本}$、$u_w$ | 逐候选计算兼容分数 |
先算 $s_w=u_w^\top v_{书}$,再沿上下文词表 softmax 得到 $p(w\mid 书)$,真实邻词本对应损失 $-\log p(本\mid 书)$。误差会同时回到中心表和上下文表。这里只由一个局部共现对演示训练接口;学到可用的统计关系需要许多文本与训练,单句不能授予一整套词义。
Word2vec可以先学词向量供别的任务使用,也可以完全不用它,直接由翻译损失学习 embedding。预训练是可选路径,不是每个神经翻译器的必经工序。固定向量提供共享起点;如何结合这一次的顺序与关系仍需后续网络。把“我给他”和“他给我”的词向量简单平均,两者结果相同,却丢掉了谁给谁;这使保留序列次序成为具体需要。以下英语窗口和完整公式是额外的独立例子,样本与主线九单位不混用。
如果还没有 NER 标签,能否从原始文本学表示?Skip-gram 把出现位置本身变成监督信号。在“She deposited money at the bank .”中,以 money 为中心、半径为 2,可形成中心—上下文对 $(\text{money},\text{She})$、$(\text{money},\text{deposited})$、$(\text{money},\text{at})$、$(\text{money},\text{the})$。窗口移到 bank,样本对也随之改变。半径、是否区分左右、是否降低高频词采样率,都会改变被学习的统计关系。
为每个中心词设向量 $v_c$,为每个上下文词设向量 $u_o$。完整 softmax 模型与一对样本的负对数似然为
$$p(o\mid c)=\frac{\exp(u_o^\top v_c)}{\sum_{w=1}^{V}\exp(u_w^\top v_c)},\qquad \ell(c,o)=-u_o^\top v_c+\log\sum_w\exp(u_w^\top v_c).$$
点积给出兼容性,指数变成正数,分母使所有上下文候选的概率和为 1。最小化语料中样本对的总损失,会提高观察到的上下文的相对概率,但不意味着每一次更新都提高 top-1 准确率。一个中心向量的梯度为
$$\frac{\partial\ell}{\partial v_c}=\sum_w p(w\mid c)u_w-u_o.$$
它比较模型当前按概率汇总的上下文向量与真实上下文向量。词表很大时,每一对样本都遍历整个分母昂贵,negative sampling 改用一个正例和 $K$ 个从噪声分布抽出的负例:
$$\ell_{\mathrm{NS}}=-\log\sigma(u_o^\top v_c)-\sum_{j=1}^{K}\log\sigma(-u_{n_j}^\top v_c).$$
正例希望点积变大,负例希望点积变小。Mikolov 等采用的一种噪声分布与词频的 $3/4$ 次方成正比。这是在区分真实共现对与采样对,并非仍然精确计算完整 softmax;单个 sigmoid 也不能直接当成规范化的 $p(o\mid c)$。抽到的负例不等于语言世界中永不相关的词。CBOW 则反过来,用窗口表示预测中心词。目标和采样细节见 Mikolov 等,2013,§2。
1.6 固定窗口网络:让相似上下文共享统计
计数表把两个不同词串当作不同条件。固定窗口神经语言模型则先查 embedding,把最近 $k$ 个向量拼成 $z_t\in\mathbb R^{kd}$,再计算
$$h_t=\tanh(Wz_t+b),\quad a_t=Uh_t+c,\quad p_t=\operatorname{softmax}(a_t).$$
假设模型已经在“gave her a”之后学会提高 book 的概率,当“gave him a”的表示和它相近时,参数共享可能帮助新组合。这里的泛化来自表示与网络结构,不能说模型从此不再受稀疏数据影响。它仍然需要足够数据学会哪些词可替换、哪些关系不可替换;而窗口外的 token 无论多重要都没有进入输入。经典起点是 Bengio 等,A Neural Probabilistic Language Model,§2。
这个结构已经提出本讲的下一项需要:如果“钥匙在红盒子里”或“钥匙在蓝盒子里”出现在句首,经过许多干扰后才问钥匙在哪,固定窗口可能根本看不到答案。扩大窗口会增加输入大小,却无法对任意长序列逐步维护状态。下一章将用一个共享更新规则处理这件事。
1.7 一句话的概率怎样拆成多次预测
下面的四句her/him计数语料是独立的历史概率练习,保持原计数和词表;它不再定义当前主线的接收者或九单位切分。
设序列为 $x_1,\ldots,x_T$,另把 $x_{T+1}$ 定义为结束符 EOS。由概率的链式法则,
$$p(x_1,\ldots,x_T,\mathrm{EOS})=\prod_{t=1}^{T+1}p(x_t\mid x_{<t}).$$
第一项的空前缀可用 BOS 表示。这是精确分解,还没有指定用计数表、RNN 还是 Transformer 实现条件概率。EOS 使模型能表示不同长度,不能把“生成达到某个固定步数”悄悄替代学习终止。
四句短语料分别是I gave her a book、I gave her a pen、I gave her a key、I gave him a book。条件固定为I gave时,her出现3次,him出现1次,you出现0次。数出3、1、0,再除以4,便得到一个可以明确检查来源的预测基线。未见组合I gave you在语言上仍可能成立,因而“观察次数为零”和“事件不可能”必须分开。接下来比较的办法,是怎样在有限观察下为这些候选分配概率。
1.8 n-gram:先限制条件,再数频率
完整前缀种类太多。n-gram 模型只保留最近 $n-1$ 个 token:
$$p(x_t\mid x_{<t})\approx p(x_t\mid x_{t-n+1:t-1}).$$
给定条件串$h$,最大似然估计为 $p(w\mid h)=C(h,w)/C(h)$。此独立计数例取$h=\text{I gave}$,所以是包含两个条件token与一个目标token的trigram。her、him、you分别得到$3/4$、$1/4$和0。若测试句恰好包含I gave you,整个句子概率会变成0。这并不证明短语不合法,只说明有限训练数据没见到。
Add-$\alpha$ 平滑把每个候选加上同样的伪计数:
$$p_\alpha(w\mid h)=\frac{C(h,w)+\alpha}{C(h)+\alpha V}.$$
这项平滑手算只设her、him、you三个候选,$\alpha=1$时得到$4/7,2/7,1/7$。her从$3/4$降到$4/7$,正好显示给未见项的质量要从重新分配中获得。另做一个包含结束符的四候选练习:词表为her、him、me、EOS,计数仍为3、1、0、0,则得到$4/8,2/8,1/8,1/8$;词表改变时分母必须同步改变。概率和仍为 1,但给大量未见事件分配相同质量往往过粗。另一种简单办法是插值:$p(w\mid h)=\lambda p_{\mathrm{bigram}}(w\mid h)+(1-\lambda)p_{\mathrm{unigram}}(w)$,在验证集选 $\lambda$。高阶上下文证据不足时借助低阶分布,而不是假装所有组合都已有足够统计。
更成熟的折扣与回退方法要同时考虑未见事件的概率质量和低阶估计。例如 Kneser–Ney 关心一个词出现在多少种不同前文之后,而不只看总频数;“Francisco”虽然在“San Francisco”里很多见,却未必适合接在任意前文之后。本章实现先用可核对的 add-$\alpha$ 或插值,进阶再读 Chen 与 Goodman 对平滑方法的实证比较。平滑缓解数据稀疏,没有取消窗口之外的信息盲区。
从计数表改用共享网络,首先改变的是怎样计算,而不是已经取得某种泛化成绩。以I gave为合法窗口,I与gave各查一个2维embedding,按顺序拼成4维输入;一组共享权重产生3维hidden,再给输出端的her、him、you、a、EOS五个演示候选各一个分数。输入embedding表另包含I、gave等token;五候选是为看清输出接口所选的局部模型,不是完整语言模型词表。因而“3维hidden”是内部表示宽度,“5维logits”才是一词一分数。不同窗口用相同参数,但输入和中间结果可以不同。
为看清最后一步,窗口模型的独立算例给定五个输出分数$(\ln4,\ln2,0,0,\ln2)$;指数为$(4,2,1,1,2)$,总和10,softmax沿五个候选归一化,得到$(.4,.2,.1,.1,.2)$。这组数演示输出接口,未声称由前面的窗口运行已训练网络产生,也不等于前面3、1、0计数的经验频率。它让未见的you有可计算概率,但概率非零并不是“已经学会正确泛化”的证据。
分布形成以后,还有两个问题尚未回答。训练需要知道哪个词实际出现在这里,以它的负对数概率计算损失;生成需要一条选择规则,把分布变成一个要追加到前缀的词。下一章将在完整生成系统中分别说明这两项工作。
1.9 切分先决定网络看见什么
当前主线把中文切成“我/昨天/给/了/他/一/本/书/。”,把英文切成“I/gave/him/a/book/yesterday/.”,另预测EOS。旧实验的“我/昨天/给了/她/一本/书”六片段切分仍保留原身份,不能拿来解释这张九单位图。这是为了对齐计算的教学切分,不是中文天然存在的唯一分词。实际系统可能按词、字符、子词或字节处理。词级词表让常见词直接对应一个编号,却难以覆盖新名字、复合词和拼写变化;字符或字节能表达更多未见字符串,但序列通常更长。同一个窗口上限下,可容纳的原文长度因此不同。
子词方法在两者之间选择可复用单位。以 BPE 的基本想法为例,先有较小单位,再依据训练语料反复合并高频相邻对;测试时按已经学好的规则切分。若一个罕见词能拆成已知子词,就不必整个替换成未知词。它仍可能把一个词切得很碎,也不保证切出的片段恰好对应词根。Sennrich 等人的机器翻译实验是理解这项设计的直接入口:Neural Machine Translation of Rare Words with Subword Units,§3–4。
实现时要把规则固定下来:是否保留大小写和标点,句首、句末、补齐位置分别是什么 token,词表是否只用训练集建立。若先用测试集建立词表或统计切分规则,评价条件已经改变。若比较两个模型的困惑度却改变了切分,每个“预测一步”的含义也已经改变。分词是模型接口的一部分,不能在报告结果后再补写。
1.10 继续阅读:表示目标与切分的完整例子
只靠一张embedding表,两个bank起初仍相同。实际语境怎样改变表示,留到第四章的self-attention回访。前面的双表word2vec已经给出表示训练目标;下面进一步展开混排消息、BPE四轮合并与共现矩阵。它们不替代翻译任务的正确性评价。
1.11 先看进入模型的对象
下面是三种手工约定,并非某个商业 tokenizer 的输出。我们保留大小写,标点单独计数,表内空格只显示边界。
| 规则 | 部分实际切分 | 会遇到的代价 |
|---|---|---|
| 按词,人工给定中文词界 | 慕容芷岚 / 在 / micro-brewery / 做 / 了 / QK-normalization / 实验 / 。 | 若姓名或复合词不在词表,用UNK会合并不同实体;词界本身需要规则 |
| 按Unicode字符 | 慕 / 容 / 芷 / 岚 / 在 / 空格 / m / i / c / r / o / - / b / r / e / w / e / r / y … | 词表较小,序列较长;字母/汉字不是同一信息单位 |
| 教学子词,预先给定片段表 | 慕容 / 芷 / 岚 / 在 / micro / - / brew / ery / 做 / 了 / Q / K / - / normal / ization / 实验 / 。 | 未见整体可组合;片段越碎,占用的位置越多;仍须定义未见字符如何回退 |
每个片段查词表变成ID,再查embedding矩阵的对应行。ID的数值大小不表示词义远近。BOS表示开始的约定,EOS是模型需要预测的结束事件,PAD只是把不同长度凑成矩形;它们不必都在每种模型里以同一种方式出现。这里的词界、空格处理也不是自然法则。
“芷”和“岚”都在词表,只保证模型能接收这两个符号;不保证它知道慕容芷岚是谁。同样,能把一个新药名拆开,不等于掌握药物知识。先把编码覆盖和事实理解分开,后面读视觉与长文档时会再次用到这个区分。
1.12 一次足够小的 BPE 学习
只为看清算法,另造小词频表:low:3, lower:2, new:1。每个词从字符加词尾符号 </w> 开始,合并不跨词界;相邻对计数乘词频;同频按符号对的字典序选先者。我们只学习四次合并。
| 轮次 | 当前最高频对(加权计数) | 采用规则 | low / lower / new 的符号序列 |
|---|---|---|---|
| 初始 | l,o=5;o,w=5;w,</w>=4 |
尚无 |
l o w </w> / l o w e r </w> / n e w </w> |
| 1 | l,o 与 o,w 同为5 |
l+o→lo |
lo w </w> / lo w e r </w> / n e w </w> |
| 2 | lo,w=5 |
lo+w→low |
low </w> / low e r </w> / n e w </w> |
| 3 | low,</w>=3 |
low+</w>→low</w> |
low</w> / low e r </w> / n e w </w> |
| 4 | e,r;low,e;r,</w>同为2 |
e+r→er |
low</w> / low er </w> / n e w </w> |
训练到此停止,四条规则有固定次序。使用时不再根据当前句子重新数频率。未见的 newer 从 n e w e r </w> 出发,前三条不能用,第四条得到 n e w er </w>;它没有忽然获得一个“newer”词条。lower 仍是 low er </w>,因为四轮里没有学到把它们全部合并的规则。
把测试词加入词频表再学习合并,是改变tokenizer,不是应用原tokenizer。回到混排句:字符级BPE若训练字符表没有“岚”,仍需要UNK、补充字符或字节回退规则。原始NMT的字符BPE与现代byte-level系统不能不加区分地混称“永远没有未知词”。
1.13 切分会改变你怎样比较模型
若同一条消息在切分A下有10个预测token,在B下有20个,两个模型即使对完整字符串给出相同的概率 exp(-10),按token平均的NLL分别是1和0.5,PPL分别为2.718和1.649。B的PPL更低,并不能据此判定它更懂这条消息;这里改变了分母。跨tokenizer比较需要明确同一文本、编码可逆性、特殊符号和长度单位,可报告每字节负对数似然等一致单位;不能把同词表内的PPL排名直接搬过来。
同样,4096个位置不是4096个词。模板、标点、子词碎片、BOS和输出预留都可能占位置。一个人名在两种语言中被拆成不同片数,也会改变同一窗口能容纳的内容。去长文档路径时,先数实际送入的ID,再讨论记忆。
1.14 共现、SVD 与 GloVe 怎样连接
另一条路线先数出共现矩阵 $C$:第 $i$ 行是中心词,第 $j$ 列是上下文,$C_{ij}$ 是按指定窗口累计的次数。直接用这一整行表示词,维度很高,而且常见词容易支配距离。可以先用关联强度重标定,例如
$$\operatorname{PMI}(i,j)=\log\frac{P(i,j)}{P(i)P(j)},\qquad \operatorname{PPMI}(i,j)=\max(0,\operatorname{PMI}(i,j)).$$
这里的概率必须来自同一种共现计数口径。PMI 比较“实际一起出现”与“按边缘频率独立出现”的比值;稀有词偶然共现也可能产生大值,所以低频处理仍然重要。对重标定矩阵 $M$ 做截断 SVD,$M\approx U_d\Sigma_dV_d^\top$,可取 $U_d\Sigma_d$ 或 $U_d\Sigma_d^{1/2}$ 作为低维表示。这两种选择对应不同的几何约定,应在比较中注明。
GloVe 也使用全局共现统计,却直接学习能拟合对数计数的向量和偏置:
$$J=\sum_{i,j:C_{ij}>0}f(C_{ij})\bigl(w_i^\top\widetilde w_j+b_i+\widetilde b_j-\log C_{ij}\bigr)^2.$$
权重函数 $f$ 调节罕见与高频共现对的影响;常用分段形式在阈值以下为 $(C_{ij}/x_{\max})^\alpha$,以上为 1。零计数不能直接取对数,因此求和与实现需相符。它与 Skip-gram 都从词的分布环境学习结构,但一个显式拟合汇总后的计数,另一个通常从局部样本对优化。见 Pennington 等,GloVe,§2。Levy 与 Goldberg 进一步说明,在特定噪声分布和优化假设下,SGNS 可联系到移位 PMI 的分解;这不意味着有限维、实际优化后的 SGNS 总与一次 SVD 完全相同:Neural Word Embedding as Implicit Matrix Factorization。
表示有没有用,要回到用途。余弦相似度、词类比和人工词对相似评分适合检查局部结构;NER、分类或翻译中的性能才直接回答下游任务问题。必须固定语料、切分、维度、训练预算和评价数据,才能解释哪项设计造成变化。相似向量也可能同时反映语义、主题、词频或语料偏差。一个词类比做对,不能证明模型理解了所有相关关系。
1.15 固定窗口留下什么问题
词典、短语表、目标语言模型与搜索已经能共同构成一个系统。神经窗口进一步让相似上下文共享参数,但窗口外的信息没有进入当前判断。若输入长短变化,固定窗口之外的信息怎样进入当前判断?下一章将用同一组参数更新共享状态,并先把条件生成走到EOS。
1.16 历史材料能说明什么
| 材料与年代 | 当时可观察的内容 | 使用边界 |
|---|---|---|
| Google 2006官方发布 | 统计机器翻译的上线与当时语言方向、评测背景 | 不是今天重跑旧算法的输出 |
| Google 2016官方PBMT/GNMT同题新闻图 | 同一中文新闻句及官方图中不同译文,允许逐项比较信息保留与流畅性 | 四栏身份以原图为准;不由“added this line”一处推定算法内部切分根因 |
| 约2021作者失败例与2021实时翻译发布 | 仍可能出现关系错误;实时语音还面临修订、等待与稳定性问题 | 失败小集合与官方系统主张分开,不拼成统一质量排名 |
| 2025-12-12与2026-02-26官方发布 | 更丰富的语境、替代译法和理解/追问交互 | 地区、平台与推出条件按原文;coming soon不等于网页已全面开放 |
2006发布;2016原图与发布;2020系统改进;2021实时翻译;2025-12-12发布;2026-02-26发布。
这些材料不包含2026年对Pierre同题的新运行结果。TranslateGemma是另一开源模型项目,不能从名称推断它就是Google Translate当前产品后端。后文的给书句、向量与搜索分数属于教学构造;Notebook结果属于各自真实实验;原论文图和官方主张另有版本与条件。分清这些身份,才能让证据承担它真正能承担的结论。
1.17 历史旁证:一句通顺的话也可能说反关系
以下是独立历史材料,不是当前开场或默认翻译主例。源句 Pierre's parents miss him. 的意思是“Pierre的父母想念Pierre”。法语构式 X manque à Y 表达的是“Y 想念 X”。依据这条规则读历史输出 Les parents de Pierre lui manquent.,X是父母、Y是Pierre,便得到“Pierre想念父母”。要保留英语中的关系,应写成 Pierre manque à ses parents.。人物都在,关系方向却因构式的安排而改变;逐词替换无法直接决定这种对应。
这是历史实录:Ernest Davis在2016年的第一版Google Translate失败小集合第22例保存了该短句及2016-10-16/12-15的记录;第十版第6例仍保留此例。第十版页头残留Updated12/26/2020,作者后续版本索引把第十版标为July2021,因此这里只称“约2021”,不伪造某一天重新运行的日期。这是作者特选失败集合,不是随机抽样benchmark;一个案例能证明存在这种失败,不能给出总体错误率。来源:第一版第22例、第十版第6例、作者版本索引。
在判断一个翻译器以前,先规定它必须保留什么:人物、物体、时间、动作方向以及必要的语气。流畅性让句子像目标语言;忠实性要求它仍在说同一件事。二者会同时影响使用价值,却不是同一个评价量。
第二章 让状态走到完整生成:从RNN到条件训练
平均词向量不能区分“我给他”与“他给我”。共享状态让输入按次序进入计算,门控把保留、写入与输出分开;然后把这组机制接成从源句到EOS的完整翻译器。各节的数学、代码和受控实验仍可独立复算。
2.1 状态随输入变,参数在时间上共享
九单位源句依次进入同一更新规则 $h_t=\tanh(Ue_t+Wh_{t-1}+b)$。$e_t$ 是当前输入的 embedding,$h_t$ 是这次处理后的状态,$U,W,b$ 是在时间位置共享的参数。$\tanh$逐坐标作非线性变换,把有限实数压到−1与1之间。运行到昨天时参数不会换一套,但状态必须使用已经处理“我”所得的结果。
取未训练的二维教学参数 $U=I,W=0.5I,b=0,h_0=(0,0)$,并给定 $e_{我}=(1,0),e_{昨天}=(0,1)$:
$$h_1=\tanh(1,0)\approx(.761594,0),$$ $$Ue_{昨天}+Wh_1=e_{昨天}+.5h_1=(.380797,1),$$ $$h_2=\tanh(.380797,1)\approx(.363399,.761594).$$
第二行把当前输入与旧状态的贡献相加,可以看到先前“我”的影响仍在。后七个单位继续用同一更新规则;未给其输入向量或实际运行结果时,只画符号状态,不伪造受训数值。
状态保存能力与任务表现需要另行验证。“我昨天给了他一本封面很厚、里面夹着许多便签的书。”仍是给书事件,但序列多了修饰内容;扩展句的位置必须重新编号,不能沿用九单位图的索引。末尾需要的早期关系要经过更多状态更新,这说明依赖路径变长,没有提供一次已测得的失败。下面保留的钥匙配对与梯度检查是不同任务,用来分别检验早期事实是否必要、反向计算是否正确。
本章用列向量书写单条序列。输入 $x_t\in\mathbb R^d$,状态 $h_t\in\mathbb R^H$,词表 logits $a_t\in\mathbb R^V$。一个基本 tanh RNN 为
$$u_t=W_xx_t+W_hh_{t-1}+b_h,\qquad h_t=\tanh(u_t),$$ $$a_t=W_yh_t+b_y,\qquad p_t=\operatorname{softmax}(a_t).$$
$W_x$ 的形状为 $H\times d$,$W_h$ 为 $H\times H$,$W_y$ 为 $V\times H$。$h_0$ 可设为零、学得参数,或由条件输入产生;必须明确采用哪一种。每读一个 token,$h_t$ 改变,$W_x,W_h,W_y$ 在这次前向计算中保持不变。把网络画成很多时间格,只是在展示同一组参数被使用多次。
旧R14–15独立扩展取暂略BOS的二维切片:$W_x=I_2,W_h=0.5I_2,b=0,h_0=0$,我、昨天、给了的输入分别为 $(1,0),(0,1),(1,1)$;得到 $(.761594,0)$、$(.363399,.761594)$、$(.827987,.881130)$。旧R16补回BOS后使用符号状态;未指定 BOS 向量,不能假称同一数值前向。
第二步最有意义的观察不是小数位,而是“昨天”到来时没有重新从零开始。$h_2$的输入中包含$0.5h_1$,所以“我”已经退出当前token位置,仍能通过上一状态影响这次结果。另一方面,$W_h$没有因为到了第二步而换一套。运行时变化的是状态,训练时优化的是参数;时间展开只是重复调用的账本。这里还没有保证早先每一项信息都保存得好。
作为课后独立复算,取一个标量例子:$h_0=0$、$W_x=0.5$、$W_h=0.8$、偏置为零,输入为 $(1,0)$。第一步 $h_1=\tanh(0.5)\approx0.462117$;第二步 $h_2=\tanh(0.8h_1)\approx0.353724$。第二个输入虽为零,状态并没有归零,因为它还带着前一步的影响。这个例子只证明计算有状态,不证明它已经学会了长距离任务。
把输出放在每一步,可以做 next-token LM 或逐位置标注;只从最后状态输出,可以做整句分类;用图像特征初始化状态并逐步预测词,可以做字幕。双向、分层或注意力会改变信息流,但不改变“参数与激活要分清”的基本要求。
2.2 LSTM 的保留、写入和输出
LSTM显式区分记忆单元 $c_t$ 与用于对外计算的隐藏状态 $h_t$;它们也不同于翻译的源摘要 $c_{src}$。一次更新把旧内容的保留、候选内容的写入和对外输出分开:$c_t=f_t\odot c_{t-1}+i_t\odot g_t$,$h_t=o_t\odot\tanh(c_t)$。实际门值由当前输入与旧隐藏状态通过可学习参数算出。
为看清动作,先给定一个标量切片:$c_{t-1}=1,f_t=.9,i_t=.1,g_t=.5,o_t=.8$。于是 $c_t=.9\times1+.1\times.5=.95$,$h_t=.8\tanh(.95)\approx.591826$。保留0.9、写入0.05、再输出经过压缩的一部分,是这次给定门值的计算,不是模型已学会了哪一种语言记忆。下列二维完整参数算例继续打开门值怎样算出,保留原来的独立身份。
在扩展的给书句中,早期人物关系需要写入,新增修饰经过时仍需保留,目标生成时再利用。这提示了三种应能分开调节的行为:写入、保留与输出。控制梯度数值大小并不能替状态决定哪些信息应当留下。因此,下一项结构选择把保存旧内容和写入新内容放进可区分的通路,并允许当前输出只暴露其中一部分。
LSTM 增加一个 cell 状态 $c_t$,把一条主要状态更新写成加性形式。本节采用常见的无 peephole、带 forget gate 版本;它不是逐字复刻 1997 年最初版本。令 $z_t=[h_{t-1};x_t]$,四个可学习变换为
$$f_t=\sigma(W_fz_t+b_f),\quad i_t=\sigma(W_iz_t+b_i),$$ $$o_t=\sigma(W_oz_t+b_o),\quad g_t=\tanh(W_gz_t+b_g),$$ $$c_t=f_t\odot c_{t-1}+i_t\odot g_t,\qquad h_t=o_t\odot\tanh(c_t).$$
各门、候选与状态均为 $H$ 维。forget gate $f_t$ 决定保留旧 cell 的比例;input gate $i_t$ 决定候选 $g_t$ 写入多少;output gate $o_t$ 决定当前 cell 有多少经 tanh 暴露为 $h_t$。门值来自当前输入、旧 hidden 和已学参数,不是教师手动指定的语义开关。初始概念与后续 forget gate 分别可追到 Hochreiter 与 Schmidhuber,Long Short-Term Memory,1997及 Gers、Schmidhuber 与 Cummins,Learning to Forget,2000。
保留的一次完整门控复算
下面完整展开旧独立二维门控算例使用的参数。取 $h_{t-1}=(0.2,-0.1)$、$e_t=(1,0)$,故 $z_t=(0.2,-0.1,1,0)$。为完整复算,令四个 $W$ 都等于
$$U=\begin{bmatrix}1&0&0.5&0\\0&1&0&0.5\end{bmatrix},\qquad Uz_t=(0.7,-0.1).$$
各偏置分别取 $b_f=(\ln9-0.7,-\ln4+0.1)$、$b_i=(-\ln9-0.7,\ln3+0.1)$、$b_o=(\ln4-0.7,0.1)$、$b_g=(\operatorname{atanh}(0.5)-0.7,-\operatorname{atanh}(0.2)+0.1)$。因此仿射输出及非线性结果为:
| 分支 | 本次仿射输出 | 门/候选向量 |
|---|---|---|
| forget | $(\ln9,-\ln4)$ | $(0.9,0.2)$ |
| input | $(-\ln9,\ln3)$ | $(0.1,0.75)$ |
| output | $(\ln4,0)$ | $(0.8,0.5)$ |
| candidate | $(\operatorname{atanh}(0.5),-\operatorname{atanh}(0.2))$ | $(0.5,-0.2)$ |
参数是为了独立手算指定的,并未训练;改变输入或旧 hidden,门值仍会按上述函数改变。参考解释:V-RNN PDF p107–115,尤其 p112;这里展示通行的 forget-gate 形式,不把它等同于1997年原始论文的每个历史细节。
沿用上表由 $z_t$ 算出的门与候选,给定旧 cell $c_{t-1}=(1,-1)$。先保留旧信息:
$$f_t\odot c_{t-1}=(0.9,0.2)\odot(1,-1)=(0.9,-0.2).$$
再写入候选内容:
$$i_t\odot g_t=(0.1,0.75)\odot(0.5,-0.2)=(0.05,-0.15),$$ $$c_t=(0.9,-0.2)+(0.05,-0.15)=(0.95,-0.35).$$
最后计算本步 hidden:
$$h_t=(0.8,0.5)\odot\tanh(0.95,-0.35)=(0.591826,-0.168188).$$
输入门控制的是“写入多少”,不决定候选的正负。输出门较小也不等于把 cell 擦掉;它限制本步可见的 hidden,cell 仍沿独立通路传下去。
多步干预的定义与边界
旧多步门控扩展另固定一个坐标:c₀=1,每步 i=.01、g=0,因此写入项为0,c₂₀=f²⁰。f=.99时为0.8179069376,f=.8时为0.0115292150。所有门值为教学干预,不是模型学到的参数。先观察保留量怎样变化;本节末尾再将这条状态通路与求导路径对上。
把保留量与求导路径对上
沿cell直接通路、把门激活固定时,一步偏导贡献为 $\operatorname{diag}(f_t)$,多步为这些因子的乘积。上面的20步干预因此既能看保留量,也能看该路径的梯度。跨度改为100步时,$0.99^{100}\approx0.366$,而 $0.9^{100}\approx2.66\times10^{-5}$,更说明乘积对forget gate的敏感性。
实际门依赖旧hidden,完整总导数还含经过hidden和门网络的其他路径;直接cell路径不等于总导数。LSTM提供可学习的保留与改写结构,不保证总梯度恒为1或任意长记忆。是否用好它仍取决于任务、优化、容量与训练分布。V-RNN PDF p113强调直接通路,p115同时交代限制。
2.3 从源句走完一次条件生成
把源句九单位送过encoder,取末隐藏状态形成固定源摘要 $c_{src}=h_n$,再通过 $s_0=g(c_{src})$ 建立decoder的初始状态。第一次预测先用BOS与 $s_0$ 更新出 $s_1$,再由 $s_1$ 形成I的词表分布;选中I后,本步新输入I与上一状态 $s_1$ 一起产生 $s_2$,再预测gave。写到 I gave 时,新送入的只有gave,它与上一状态 $s_2$ 更新出 $s_3$,随后才形成him的分布;him仍是候选,选中后才成为下一步输入。后续同样经过状态更新、词表分布、选择和反馈,依次接入him、a、book、yesterday与句号,最终选中EOS结束。图旁的完整前缀用于记下已生成内容,不表示每一步都把整段前缀重新送入这一个RNN。
I gave him a book yesterday . EOS 是这个教学任务的合适目标。这里展示的是合适目标及生成接口,不是受训模型在这句话上的实测输出。源长9、目标文本7项再加EOS,共8个预测目标;两侧长度不同没有矛盾。句号有自己的下一步预测,不能用它代替EOS。
固定的是源接口,不是每一步decoder状态或输出分布。图中的 $s$ 是decoder递推状态的总记号;采用LSTM时,它可包含hidden与cell,而 $c_{src}$ 只指源摘要。图保留 $c_{src}→s_0$ 作为初始化背景,后续活动连接是“上一状态+本步新输入→当前状态→词表分布”,源条件沿状态传递,不在每一步重新注入。另一种实现可以每步再次注入源条件;具体实验必须声明使用哪一种。原LAB02采用双向源编码、decoder零初始化和逐步注入,固定组对有效源状态取均值,动态组逐次读取。因此不能把本段末状态初始化的示意当成LAB02训练配置。
扩大状态、改进训练和门控都可能改善这个已经可用的接口。一个短例没有证明固定摘要装不下;有限维实向量也不是长句必然失败的数学定理。是否有必要保留源位置供每步读取,要用任务与受控结果继续判断。
2.4 变长输入经过什么接口进入变长输出
令源 token 为 $x_{1:n}$,encoder 得到 $h_1,\ldots,h_n$。此处为明确一种实现,固定表示接口取 $c_{src}=h_n$,用它初始化 $s_0=g(c_{src})$;随后源条件沿解码状态向前传递:
$$s_i=f_{\mathrm{dec}}(E_y[y_{i-1}],s_{i-1}),\qquad p(y_i\mid y_{<i},x)=\operatorname{softmax}(Ws_i+b).$$
这里 $c_{src}$ 是源句条件,不是 LSTM cell。每一步再拼接固定条件是另一种可实现的设计,上面这一式选择初始化接口;LAB02实际采用逐步注入,二者不能混成同次运行。输入长度 $n$ 与输出长度 $m$ 不必相同,EOS 决定何时停止。完整条件分解为
$$p(y_{1:m},\mathrm{EOS}\mid x)=\prod_{i=1}^{m+1}p(y_i\mid y_{<i},x_{1:n}).$$
可以沿三个时刻检查图是否读对:源端读完以后,$c_{src}$在这次生成中保持不变;目标端读BOS后形成$s_1$,读I后形成$s_2$,读gave后又形成下一状态。固定的是源条件接口,并非所有解码状态被冻结。目标前缀在变化,模型分布也可变化;中文“昨天”虽然较早出现,仍可能在较后的英文位置表达。这解释了两个不同长度、不同次序的序列怎样接起来。
固定接口意味着源信息对 decoder 的影响必须经由 $c_{src}$,这是一项计算图事实。它可能使优化、细节保存或长句泛化困难,却不能简化成“有限维向量在数学上一定装不下长句”。真实结果还受参数容量、表示精度、训练数据和长度分布影响。2014 年的工作已经表明,这个基线在翻译上具有实际价值。
2.5 teacher forcing 改变输入来源,没有改变目标
生成的下一步输入来自刚刚选择的词;训练已有参考译文,可以为每个位置提供正确历史。右移对齐如下:
| 输入位置 | BOS | I | gave | him | a | book | yesterday | . |
|---|---|---|---|---|---|---|---|---|
| 本位置目标 | I | gave | him | a | book | yesterday | . | EOS |
在gave这一输入行预测him时,可用历史只有BOS、I、gave及完整中文源句。him作为标签用于求loss,不能先送入同一预测位置。这就是teacher forcing使用真实历史的含义;所有位置的误差汇总后,通过输出头、decoder、encoder与embedding更新共享参数。
训练与生成使用同一套条件概率模型,下一步历史的提供者不同。生成若选错一个词,后续条件会随之偏离真实历史;若第一个错误已经发生在两种前缀仍完全相同的位置,就不能将它归咎于更早的自馈错误。完整生成、EOS和任务评价仍须单独检查。
2.6 一次训练:分布、loss 与梯度
当前主线的输出头小例另设三个候选him/yesterday/book,给定logits $(0,\ln2,\ln3)$,目标book概率为1/2,loss为 $\ln2\approx.693147$。三个候选只为手算,不是实际词表。下段her/a/book保留为旧独立算例,数值相同不代表两者是同一次前向。
交叉熵的独立三候选例使用前缀 I gave her a、目标 book:候选 her/a/book 的 logits 为 $(0,\ln2,\ln3)$,概率为 $(1/6,1/3,1/2)$,损失为 $-\ln(1/2)\approx0.693147$,梯度为 $(1/6,1/3,-1/2)$。它与前面的五候选网络是两个明确分开的规模选择。
作为另一项独立三候选练习,设三个候选 token 的 logits 为 $(\log2,0,0)$,则 softmax 为 $(1/2,1/4,1/4)$。若真实目标是第二个 token,交叉熵为 $-\log(1/4)=\log4\approx1.386$。模型虽然给出了三个概率,训练损失只从真实标签取出对应的负对数;但反向传播会调整所有 logits:
$$\frac{\partial\ell}{\partial a_j}=p_j-\mathbb 1[j=y].$$
本例梯度为 $(0.5,-0.75,0.25)$。梯度下降在直接调整 logits 的局部直觉上会降低错误候选、提高目标候选;实际网络参数同时影响许多样本,不能保证每次更新让全部位置都变好。稳定 softmax 应先减去最大 logit;这个平移不改变分布。
训练答案并不需要每个位置另请人标注。对一条现成文本,当前前缀就是输入,紧接着的token就是标签;沿句子移动位置,就重复得到同一类训练问题。模型看见标签来计算损失,与模型把标签提前作为预测条件,是两回事。
对“I gave her a book yesterday .”,输入可写为“BOS I gave her a book yesterday .”,对应目标为“I gave her a book yesterday . EOS”。在输入 gave 的位置预测 her,在输入 book 的位置预测 yesterday。错位一格的目的,是防止把当前答案直接作为当前预测的输入。后面 causal mask 允许读取本位置,也必须和这个错位约定一起理解。
给定一条训练样本,负对数似然为
$$L=-\sum_{t=1}^{T+1}\log p_\theta(x_t\mid x_{<t}).$$
这里临时用x表示通用语言模型的文本序列;翻译时恢复独立源条件,写成 $L=-\sum_t\log p_\theta(y_t\mid y_{<t},x_{src})$。目标语言评分与条件翻译共用概率形式,但不能省掉后者的源信息责任。
原本连乘的概率变成求和,数值更稳定,也能逐位置追踪错误。训练用真实前缀,因为目标正是估计数据在这些条件下的概率。部署时前缀里可能有模型自己的输出,两种条件分布并不总相同。
批量训练遇到不同长度序列时,PAD 只是补齐工具。应从损失与 token 计数中排除 PAD,明确是否计入 EOS。若对每个批次先求平均、最后又等权平均批次,大小不同的批次可能被错误加权。想得到整套测试语料的平均负对数似然,应先累加总负对数似然,再除以实际目标 token 总数。
2.7 perplexity 在什么条件下可比较
用自然对数计算每 token 平均损失 $\bar\ell$,困惑度为
$$\mathrm{PPL}=\exp(\bar\ell)=\exp\left[-\frac1N\sum_{t=1}^{N}\log p_\theta(x_t\mid\text{合法前缀})\right].$$
若两个目标的概率分别为 $1/2$ 和 $1/4$,则 PPL 为 $\sqrt8\approx2.828$。它可以理解为一种等效的不确定程度:如果每步都在 $K$ 个等概率候选中预测,PPL 恰好是 $K$。真实模型的分布并不均匀,因此 PPL 不是每一步真正保留的候选数量,更不是“有多少个词答错”。
比较时必须固定测试数据、分词、词表和未知词处理、上下文可见范围、EOS/PAD 口径。词级模型与字节级模型的 per-token PPL 不能直接排序;可以改用同一原文上的每字符或每字节对数损失,但仍需处理编码与归一化细节。更低 PPL 说明在这个评价分布上给真实序列更高的平均概率,不自动推出事实更可靠、翻译更忠实或长距离查询更准确。
2.8 从分布到文本,需要另一个选择规则
训练决定 $p_\theta$,解码决定怎样使用它。Greedy 每次选最大概率 token;随机采样按分布抽取。温度采样先计算 $p_j^{(\tau)}\propto\exp(a_j/\tau)$,$\tau>0$。温度降低通常使分布更尖,升高使其更平;$\tau\to0$ 的极限接近 greedy,但实现中不能真的除以 0。
Top-$k$ 只保留概率最大的 $k$ 个候选并重新归一化;top-$p$ 保留按概率从高到低累积达到阈值 $p$ 的最小候选集合,再归一化采样。前者固定候选个数,后者随分布形状改变个数。核采样的原始讨论见 Holtzman 等,The Curious Case of Neural Text Degeneration,§3。这些规则改变生成分布;用温度修改后的概率计算 PPL,相当于换了被评价的模型,不能与原始 logits 的 PPL 混报。
用R13的短前缀追一次身份变化更容易分清这个过程。已有I gave her a,分布给book、pen、key概率$.6,.3,.1$;若选book,它起初是候选,选中后才成为已知前缀的一部分。两token窗口原先能看her a,下一次变成a book,更早的I gave her已不再直接进入输入。温度只改如何选词,不能让被窗口丢掉的内容重新出现。若很早的一条事实还决定答案,就需要扩窗,或维护一个能将历史影响带向后续的状态。
生成循环从 BOS 或用户前缀开始,运行模型得到下一步分布,选择 token,附加到前缀,直到 EOS 或长度上限。上限防止无限运行,但“撞到上限”与“模型主动结束”应分别记录。固定种子有助于重现同一次采样;跨硬件、并行核或软件版本仍可能有数值差异。展示一句流畅文本只是一个样本,评价要包含多次输出、不同前缀与相同资源条件。
2.9 展开之后,BPTT 就是链式法则
单步更新说明怎样运行,多位置监督说明怎样学习。可以先在展开图上任选两个输出位置:它们各自产生loss,却都依赖同一$W_h$。若只保留某一次调用的梯度,就忽略了这项参数对其他位置的影响。因此需要沿时间依赖追溯,并把各次使用的贡献相加。R16恢复BOS后使用的是符号训练图,不应将前面的二维$h_1,h_2$数值直接贴到新图。
设目标 $y_t$ 是与输入错位后的下一 token,总损失 $L=\sum_{t=1}^{T}\ell_t$,其中 $\ell_t=-\log p_t[y_t]$。为了写清反向传播,定义输出误差 $e_t=p_t-\operatorname{onehot}(y_t)$,再令 $\delta_t=\partial L/\partial u_t$。从最后一步反向递推:
$$\delta_t=\left(W_y^\top e_t+W_h^\top\delta_{t+1}\right)\odot(1-h_t\odot h_t),\qquad \delta_{T+1}=0.$$
括号里有两条来源。第一项是本时刻预测错误传回来的梯度;第二项是后续所有损失通过状态链传回来的梯度。漏掉第二项,模型仍可能降低局部预测损失,却没有正确学习当前状态对未来的作用。这就是 backpropagation through time 的核心。
共享参数的梯度汇总为
$$\nabla W_y=\sum_t e_th_t^\top,\qquad \nabla b_y=\sum_t e_t,$$ $$\nabla W_x=\sum_t\delta_tx_t^\top,\qquad \nabla W_h=\sum_t\delta_th_{t-1}^\top,\qquad \nabla b_h=\sum_t\delta_t.$$
若输入来自 embedding,$\partial L/\partial x_t=W_x^\top\delta_t$ 再累加到对应词表行;同一个词出现多次,需要相加,不能覆盖。若 $h_0$ 可训练,还要保留 $W_h^\top\delta_1$。这些式子使用“时间损失求和”的约定;若前向取平均,所有梯度也要除以相同的有效目标数。经典训练困难分析与梯度范数裁剪见 Pascanu、Mikolov 与 Bengio,2013,§2–3。
2.10 梯度检查为什么值得先做
一段手写 BPTT 代码能运行,不代表梯度正确。对一个参数元素 $\theta_i$,使用中心差分
$$g_i^{\mathrm{num}}=\frac{L(\theta_i+\varepsilon)-L(\theta_i-\varepsilon)}{2\varepsilon}$$
与解析梯度比较。检查应使用小网络、短序列、float64、固定输入和参数,关闭 dropout;损失必须是同一个确定函数。过大的 $\varepsilon$ 有截断误差,过小则有浮点抵消,可先用 $10^{-5}$ 并检查邻近数量级。既报告最大绝对误差,也报告整体相对误差 $\|g_a-g_n\|/(\|g_a\|+\|g_n\|+10^{-12})$,不要对接近零的元素机械要求很小相对误差。
下面是足以检查共享循环权重的 NumPy 小程序。它用二元输出避免词表代码掩盖时间链,目标序列为 $(0,1,0)$。这是可复制的检查示例,不是长依赖性能实验。
import numpy as np
x = np.array([1., 0., -1.], dtype=np.float64)
y = np.array([0., 1., 0.], dtype=np.float64)
wx, wy = 0.5, 0.7

def forward(wh):
    h = np.zeros(len(x) + 1, dtype=np.float64)
    for t in range(len(x)):
        h[t + 1] = np.tanh(wx * x[t] + wh * h[t])
    logits = wy * h[1:]
    loss = np.sum(np.logaddexp(0., logits) - y * logits)
    p = 1. / (1. + np.exp(-logits))
    return loss, h, p

wh = 0.8
loss, h, p = forward(wh)
du_next, analytic = 0., 0.
for t in reversed(range(len(x))):
    du = (wy * (p[t] - y[t]) + wh * du_next) * (1. - h[t + 1]**2)
    analytic += du * h[t]
    du_next = du
eps = 1e-5
numeric = (forward(wh + eps)[0] - forward(wh - eps)[0]) / (2 * eps)
print(analytic, numeric, abs(analytic - numeric))
如果把循环中的 analytic += 改成赋值,或者删掉 wh * du_next,检查应能暴露错误。检查通过说明这段代码计算的是所写损失的梯度;它不证明目标定义合理,也不证明训练能达到想要的能力。
2.11 为什么远处的信用分配困难
先分清两个需要检验的问题:状态在前向中是否带来早先信息的影响,末尾损失在训练中是否能改变早期的处理。RNN计算图为二者提供了通路,但“箭头连得上”并不等于模型已经学会使用它。一个有判别力的任务要让答案真正随早先事实改变,而不能只靠常见标签或末尾词猜中。
考虑一条受控输入:“蓝扣钥匙放进赭色盒子”,接着给出若干不涉及钥匙的干扰事件,末尾问钥匙在哪里。正确答案必须依赖前面那条事实。我们可以把盒子颜色均匀随机,确保最后几个词不泄露答案,再改变事实与问题的距离。这样测到的才是对远处信息的利用;把 A→B→C 周期从 12 步加长到 18 步,只需要局部转移,并不构成这种证据。
最直接的配对检查,是保持电话、杯子和末尾问题逐字相同,只把开头的赭色盒子改成灰色盒子。正确答案随之变化。任何只依赖共同后缀的确定性系统都无法同时答对这对样本;这给“使用远处信息”一个可以反驳的标准。逐步增加干扰距离,才是在给这条通路增加负担,而不是单纯把输入写得更长。
若末尾答错,loss要影响开头的写入,就必须穿过中间多次更新。基本 RNN 的单步状态 Jacobian 为
$$J_t=\frac{\partial h_t}{\partial h_{t-1}}=\operatorname{diag}(1-h_t^2)W_h,$$
从 $s$ 到 $t$ 的梯度包含 $J_tJ_{t-1}\cdots J_{s+1}$。许多小于 1 的因子连乘,远处损失就难以改变早期写入;许多较大的因子连乘,梯度可能爆炸。矩阵乘积还受方向、奇异值和非线性饱和影响,不能只看一个权重或把所有训练现象归结为单个特征值。tanh 饱和时导数接近零,会进一步削弱某些路径。
梯度范数裁剪处理的是更新不稳定。把所有待更新参数的梯度拼成 $g$,设置阈值 $\tau$:
$$g\leftarrow g\,\min\left(1,\frac{\tau}{\|g\|_2}\right),\qquad \|g\|_2=\sqrt{\sum_i g_i^2}.$$
零范数时保持零即可。超阈值后保持整体方向、压小长度;这不同于逐元素裁剪。裁剪可以防止一次大梯度把参数推得过远,不能恢复已经衰减到几乎零的远程信号。实验里应同时记录裁剪前范数、裁剪触发比例与任务准确率,避免仅凭损失不发散就宣称记忆问题已解决。
完整 BPTT 需要保存用于反向传播的时间激活。截断 BPTT 每隔若干步把状态与之前的计算图断开:前向状态的数值仍可传到下一段,梯度却不能穿过截断边界。这减少内存与计算,也限制了训练时直接分配长期信用的范围。不要把“状态没有清零”误认为“梯度仍能回到整条历史”。
2.12 用钥匙配对定位真正的长程要求
当前同事件长句用于观察依赖路径,未报告模型失败。下面红蓝盒与钥匙是另外的受控任务,完整保留其对照原则;它们不再是默认给书主线。
旧课堂扩展采用红盒/蓝盒配对:只改变早期位置事实,共同后缀与末尾问题保持不变。下面保留另一份“蓝扣钥匙/赭色盒与灰色盒”的独立文字样本,它采用同一配对原则,但没有沿用课堂红蓝情境的任何运行成绩。
第一条写“钥匙在赭色盒子”,另一条只把颜色改为灰色;中间干扰和末尾问题完全相同。两条正确答案不同,迫使系统使用早期差异。序列长不一定要求长依赖;这种配对才给出检查标准。状态是否保留、读出能否使用、末尾loss能否改变早期写入,是三个可分别检查的问题。
2.13 GRU、双向与堆叠各改变了什么
GRU 把长期 cell 与可见 hidden 合并为一类状态,用更新门和重置门调节计算。一种常用约定为
$$z_t=\sigma(W_zx_t+U_zh_{t-1}+b_z),\quad r_t=\sigma(W_rx_t+U_rh_{t-1}+b_r),$$ $$\widetilde h_t=\tanh(W_hx_t+U_h(r_t\odot h_{t-1})+b_h),$$ $$h_t=(1-z_t)\odot h_{t-1}+z_t\odot\widetilde h_t.$$
在本约定里 $z_t\approx0$ 倾向保留,$z_t\approx1$ 倾向改写。有些论文或框架把 $z_t$ 与 $1-z_t$ 的角色交换,或把 reset 放在循环投影之后;实现比较必须检查具体公式,不能只对齐变量名。GRU 的门较少、参数通常较少,但同等 hidden 宽度不等于同等参数预算,也没有不依赖任务的胜负结论。早期门控单元可读 Cho 等,2014,§2.3。
双向 RNN 用一条从左向右和一条从右向左的状态链,在位置 $t$ 拼接 $[\overrightarrow h_t;\overleftarrow h_t]$。它适合输入整句已经给定的 NER 或翻译 encoder。若用右向状态预测尚未出现的下一 token,就把答案相关的未来信息带进了自回归 LM,训练目标被破坏。双向不是“记忆更长”的同义词,它直接改变可见范围。
堆叠 RNN 则让第 $\ell$ 层在每个时间点接收第 $\ell-1$ 层的输出:$h_t^{(\ell)}=f^{(\ell)}(h_t^{(\ell-1)},h_{t-1}^{(\ell)})$。深度方向与时间方向是两条不同轴;每层通常有自己的参数,同层跨时间共享参数。加深可能提高表示能力,也会增加优化与运行成本。
到这里,条件生成的内部已经可逐步核对。先用以下独立扩展区分状态传递与梯度截断,再在下一章学习逐位置读取,并借候选评分与论文证据检查搜索、优化和源信息接口。视觉条件的完整展开留在第六章。
2.14 同一条历史,两种不同的截断
作为独立流式延伸例,把门禁日志分成1–4和5–8两块。第一块处理到 h_4。第二块用 stop_gradient(h_4) 作为起点,数值与 h_4 相同,若第2条登记了钥匙持有人,这条信息若已被保留,仍可以影响第8条的当前持有人输出;但第8条loss的梯度不会穿过这个边界去改第2条的写入过程。第二块仍会对第5–8条使用的同一组参数产生梯度。若块间做了参数更新,携带状态还是旧参数算出的值,并没有重新编码全部过去。
state = initial_state()
for chunk in stream_chunks:
    state = detach(state)       # 保留数值,截断本次求导历史
    outputs, state = rnn(chunk, state)
    loss(outputs, targets).backward()
    optimizer.step(); optimizer.zero_grad()
这是解释截断的伪代码,不对应新的训练成绩。若改成每块 state=initial_state(),那是同时清掉前向历史,改变了可用信息。将“detach”和“清零”混同,会误以为截断窗口就是模型能记住的最大长度。更长梯度跨度也不保证学会任务;它只是允许远处写入收到这次误差的信用信号。
2.15 GRU 符号先统一,才比较实现
本讲把z当写入比例:h=(1-z)⊙h_old+z⊙candidate;Cho2014把z当保留比例:h=z_Cho⊙h_old+(1-z_Cho)⊙candidate。两者换算为 z=1-z_Cho。例如旧值2、候选6,本讲z=.25得到3;原论文要用z_Cho=.75才得到同一数值,不能把.25原样搬过去。
两个门通常由当前输入与旧状态的仿射函数接sigmoid得到:z=σ(W_z x+U_z h_old+b_z)、r=σ(W_r x+U_r h_old+b_r),逐特征取0到1的值。这里z采用上面的写入约定。
Cho候选为 tanh(Wx+U(r⊙h_old))。PyTorch2.9的GRU采用 tanh(W_in x+b_in+r⊙(W_hn h_old+b_hn)),reset在投影后。令h=(1,2)、r=(1,0)、U的两行为(1,1)/(1,-1):投影前reset给(1,1),投影后给(3,0),都是tanh前的值。非对角U使两者一般不同。reset只控制候选中的旧状态通路;即使r=0,最终保留支路仍可能留下旧状态。
门控、双向和堆叠解决不同设计问题。整句命名实体识别可用双向;连续传感流常要求因果;多层把局部模式逐级组合,代价是更多计算与优化难度。选择它们应先问输出何时需要、允许看见哪些输入,再问深度和隐藏宽度。
来源:同版读本第二章;lecture_7物理11–60、91–116连续推演;Cho2014 v3 §2.3、PyTorch2.9 GRU定义。门禁是应用情境;数值门控与解析梯度是构造核验;LAB01 C的短训练不升级为能力评测。
2.16 一个强序列系统,仍有不同研究选择
现在已经能从完整源句出发,经共享递推、源条件和合法目标前缀产生译文。LSTM进一步把保留、写入与输出分开,给长期信息和信用分配提供可学习的通路。这是一条可工作的强路线,是否继续使用它应由任务和证据决定。
下一章先保留逐位置源表示,让每个目标步骤按当前前缀重新读取。读清这条机制以后,再借2014年的源序反转与论文结果,比较信息组织、优化和读取接口各自改变了什么。
第三章 从固定摘要到逐次读取
固定摘要已经能完成翻译。新的研究选择来自两个问题:同样的信息,组织顺序会不会改变可学性;保留源位置、逐次读取,又会改变什么?本章把历史选择、完整机制与任务证据接起来,最后用保存的失败样本区分模型评分和搜索。
3.1 固定接口成功以后,还能怎样保存源信息
现在保留九个源位置的编码表示,而不是只把最后一个摘要交给decoder。目标已知前缀为 BOS I gave,当前还没有him。由这个合法目标状态形成query,对源位置逐项打分,沿源位置归一化,再汇总value;写到 I gave him a book 之后,又可形成新的query去读取时间。每个时刻都仍要生成分布、选词并反馈,不能把中间的a、book略成不存在的步骤。
为核算读取到词表的完整链,另建R7.2局部三槽教学构造。槽标签为他、书、昨天,只是从九单位事件中选出的三项;下面的二维数并不是九位置encoder的实测状态,更不是旧checkpoint输出。给定未缩放点积、$q=(1,0)$:
| 槽 | key $k_j$ | value $v_j$ | $q^\top k_j$ |
|---|---|---|---|
| 他 | $(1,0)$ | $(2,0)$ | 1 |
| 书 | $(0,1)$ | $(0,4)$ | 0 |
| 昨天 | $(1,1)$ | $(1,2)$ | 1 |
源位置softmax给出 $\alpha\approx(.422319,.155362,.422319)$,故
$$c=\sum_j\alpha_jv_j\approx(1.266956,1.466087).$$
再明确一个教学输出矩阵 $G=\begin{bmatrix}2&0&0\\0&1&0\end{bmatrix}$,目标词表依次为him、book、yesterday。$cG\approx(2.533913,1.466087,0)$,词表softmax得到约 $(.702690,.241553,.055757)$;若当前标签是him,这个局部输出头的loss约为 $-\ln(.702690)=.352839$。第一次概率轴是三个源槽,第二次是三个目标候选;高读取权重不是某个英语词的概率。真实decoder还会使用目标状态和完整词表,这个小G只闭合局部接口。
独立从基线只改 $q'=(0,1)$,K/V/G保持不变,得到源权重 $(.155362,.422319,.422319)$、$c'\approx(.733044,2.533913)$,词表概率变成 $(.241553,.702690,.055757)$。需求改变可以改变读取与预测;这些人为参数没有证明“第二维就是书”。译文目标的负对数概率可把误差信号经G、加权和、softmax与打分传回源状态和目标状态,使读取从任务数据中学习。
下面保留旧READ的六片段她/her语境、数值与干预作为独立扩展;它不再承担当前九单位翻译的运行身份。2014年的真实加性打分与这两个未缩放点积构造也分别说明。
固定摘要的成功证明这是一条可行路线,但没有替所有任务决定源条件该怎样组织。一个汇总向量需要同时服务整条译文;写主语、接收者和时间时,所需信息却可能不同。可以加宽状态、改善训练与门控,也可以保留每个源位置,推迟到目标需要时再决定读什么。
有限维实向量不是“数学上绝不可能编码任意句子”的证明。实际效果受有限精度、任务复杂度、训练覆盖和可学习读出影响。给书短句在这里解释接口:它本身没有证明固定摘要已经不够。长短句表现和受控比较将在完整读取机制之后提供证据。
3.2 让当前目标决定重新读哪里
以下旧读取扩展保留R7.1六片段“她/her”的接口、READ小算例及论文证据。它们是独立历史扩展;新九单位“他/him”及新三槽数值已在本章开头完整定义,不把两套位置或运行身份拼在一起。
固定摘要每步重复提供同一份源条件;动态读取保留逐位置源表示。源句与其六个表示不动,目标前缀从BOS增长到I、I gave,再到需要yesterday的位置,每一步重新读取。完整输出仍包含a、book、句号与EOS,不因只放大her和yesterday便跳掉中间生成。
3.3 从目标需要走到下一词分布
设第 $i$ 个目标步骤使用 query $q_i$,源位置提供 key $k_j$ 和 value $v_j$。一次软读取有三步:
$$e_{ij}=\operatorname{score}(q_i,k_j),\qquad \alpha_{ij}=\frac{\exp(e_{ij})}{\sum_{r=1}^{n}\exp(e_{ir})},\qquad c_i=\sum_{j=1}^{n}\alpha_{ij}v_j.$$
一条读取权重回答“这一刻从哪些源位置取信息”,还没有回答“英文下一词是什么”。即使某个源位置标签写着“书”,给它较大权重也不等于book的输出概率较大;它传来的是一个向量,还要经过解码状态与词表头。因而必须把读到什么、怎样用于预测这两段接通。
Key 参与决定匹配权重,value 是实际被加权汇总的内容。一个位置的 key 与 value 可以从同一源表示产生,但它们不必相等。$c_i$ 随目标步骤改变,所以不再只有一份对整句固定的读取结果。它仍是向量,不能因名称是 context 就等同于整个原始上下文窗口。
读取之后还要接回生成模型。以一种常见组织方式为例,先用 $s_{i-1}$ 形成 query 和 $c_i$,再更新 $s_i=f(s_{i-1},E_y[y_{i-1}],c_i)$,最后由 $[s_i;c_i]$ 或相应隐层算词表 logits 与 softmax。某些模型先更新 state 再 attention,具体次序按论文或代码核对。仅有一张权重热图,尚未描述完整翻译器。
3.4 保持读取外壳,只替换 scorer
英文目标读中文源序列时,需要一种能让当前需求改变源位置排序的打分函数。先看2014年实际采用的算子,再用独立小例核算读取。
2014 年的动态软对齐使用小神经网络打分。用本章接口重写的一般形式是
$$e_{ij}=v_a^\top\tanh(W_qq_i+W_kk_j+b_a).$$
Bahdanau 原式使用前一 decoder state 与双向 encoder 的 annotation;这里的 Q/K/V 术语是帮助统一理解的后续记法,不意味着原论文已经采用 2017 年多头投影结构。原始模型及 alignment 公式见 Bahdanau 等,§2.2、附录 A。
非线性不是可随意省略的装饰。若只对拼接向量作线性打分,$e_{ij}=a^\top q_i+b^\top k_j$,则固定 query 行中 $a^\top q_i$ 是所有 key 共有的常数,在 softmax 分子分母中会抵消:
$$\operatorname{softmax}_j(a^\top q_i+b^\top k_j)=\operatorname{softmax}_j(b^\top k_j).$$
这样换 query 并不会改变权重,失去了我们想要的动态匹配。加上 tanh 后,query 会改变各 key 经非线性变换后的相对分数。点积 $q_i^\top k_j$ 则直接包含两个向量的相互作用,也能形成依赖 query 的权重。选择 scorer 是建模选择,不是把所有“求和”都叫同一种 attention。
3.5 一次独立、可核算的读取
为看清前面整套翻译图里的一个局部,这里另建三来源、二维向量账本。它借用“她、书、昨天”来标源位置,并不是把六位置示意的训练张量直接抄下来。固定这些小数值之后,可以逐步区分需求、匹配线索、内容向量与输出词。
沿用旧READ独立扩展的二维教学构造,先用未缩放的点积,目的是区分匹配与内容,不给向量维度指派未经训练的语义。query 为 $q=(1,0)$,选取“她、书、昨天”三个源位置,key、value 为
| 位置 $j$ | $k_j$ | $v_j$ | 分数 $q^\top k_j$ |
|---|---|---|---|
| 1,她 | $(1,0)$ | $(2,0)$ | $1$ |
| 2,书 | $(0,1)$ | $(0,4)$ | $0$ |
| 3,昨天 | $(1,1)$ | $(1,2)$ | $1$ |
指数为 $(2.718282,1,2.718282)$,分母约为 $6.436564$,得到权重
$$\alpha\approx(0.422319,0.155362,0.422319).$$
逐维相加,结果为
$$c=0.422319(2,0)+0.155362(0,4)+0.422319(1,2) \approx(1.266956,1.466087).$$
为闭合到词表概率,再给出教学投影 $G=\begin{bmatrix}2&0&0\\0&1&0\end{bmatrix}$,小词表依次为 her、book、yesterday。得到 logits $cG\approx(2.533913,1.466087,0)$,第二次 softmax 约为 $(0.702690,0.241553,0.055757)$。第一次 softmax 在源位置间分配读取权重,第二次在目标词表上归一化,两个概率对象不同。这个小投影省略真实 decoder 的其余状态计算,参数均为给定数值,不能据此宣称模型会翻译。
权重非负且和为 1,所以这个单头输出在当前三个 value 的凸包内;之后的输出投影、残差和 FFN 可以把表示移出这个凸包,不能把这一局部性质扩大到整个 Transformer。计算时保留充分精度,最后才舍入;先把权重粗略写成 0.42、0.16、0.42,只适合解释,不适合与实现做严格比较。
3.6 两条独立干预支路
只算出一个context,还不足以知道哪一部分在起作用。把两个可能原因拆开,会得到两个不同问题:需求变了但来源没变,读取分配是否改变?来源传递的内容变了但匹配线索没变,权重还能保持吗?两次干预必须各自回到原始基线,才不会把第一项变化混进第二项。
两次干预分别从同一基线出发,预测头 G 均保持不变。第一次固定 K 与 V,换成 $q'=(0,1)$。分数变为 $(0,1,1)$,权重变为 $(0.155362,0.422319,0.422319)$,输出变为约 $(0.733044,2.533913)$。读取需求改变,位置 2 的权重上升,输出随之改变。
第一项 q 干预经同一个 G 得到logits约(1.466087,2.533913,0),her/book/yesterday概率约为(.241553,.702690,.055757)。yesterday对应G第三列为零,因此它的logit仍为0。
第二项 V 干预先独立恢复原 q/K/V 基线,再只把 $v_2$ 从 $(0,4)$ 改为 $(0,8)$。因为 scorer 没有使用 V,权重保持原值;输出却变为约 $(1.266956,2.087537)$,第二维增加 $4\times0.155362\approx0.621450$。这区分了“读哪里”与“那里传来什么”。真实 self-attention 中 Q、K、V 都可能由同一 X 投影,改原始 token 通常同时影响三者。独立改 Q 或 V 是有意拆开计算的机制实验,不能冒称自然语言只换一个词时网络一定如此变化。
3.7 译文误差怎样教会读取
正确目标词的概率低,会先产生词表预测的loss。这条信号经输出头回到context,再经加权和回到value与权重,经softmax和打分回到需求与匹配表示。源表示和解码状态同样可以更新。于是普通的平行译文就能教读操作,不必另外为每一个词标一条唯一对齐线;模型要学的是有助于任务预测的读取方式。
从机制返回同一次研究选择
现在检查旧六片段诊断样本“我昨天给了她一本书→I gave him a book yesterday . EOS”,原来笼统的“模型没记住”可以拆得更具体:源位置是否保留了角色信息,当前目标需求是否能读取它,读到的内容是否提高her的相对分数,搜索又是否保留了正确候选?这些问题来自已经学过的计算,不只是换一个模型名字。
固定摘要把源句压成一次条件;逐位置接口保存一组编码表示,按每个合法前缀的需求重新读取。任务误差能训练读操作,这说明接口有可学习的用途,没有证明它会修好当前错译。源序反转改善和强固定向量的长句表现仍支持继续旧路线。
下一步可以做待验证的源序(正/反)×接口(固定摘要/动态读取)2×2。使用同一小型翻译数据与原始参考输出;每列的正反序对照固定编码器方向、深度、宽度、参数量和训练/搜索预算。跨列完整报告系统配置与容量差别,等容量对照另列。主要观察受控接收者词对的teacher-forced正确词NLL与分距错误率;另外报告自由生成BLEU及推理成本。先控制搜索,以免把搜索差距误作条件信息缺失。若动态读取没有可复现收益而代价更大,保留旧路线。若改善只在反转条件出现,也不能把全部改进归于读取接口。
局部梯度细式与其他路径
设某行输出 $c=\sum_j\alpha_jv_j$,上游梯度 $g=\partial L/\partial c$。暂把 Q、K、V 当成独立输入,则
$$\frac{\partial L}{\partial v_j}=\alpha_jg,\qquad \frac{\partial L}{\partial e_j}=\alpha_jg^\top(v_j-c).$$
后一个式子说明,调高一个位置的分数是否有利,取决于该位置的 value 相对当前汇总输出怎样影响损失。对于 scaled dot product,
$$\frac{\partial L}{\partial q}=\frac1{\sqrt{d_k}}\sum_j\frac{\partial L}{\partial e_j}k_j,\qquad \frac{\partial L}{\partial k_j}=\frac1{\sqrt{d_k}}\frac{\partial L}{\partial e_j}q.$$
在真实网络里还要把这些梯度经投影矩阵传回 X,并汇合所有使用同一输入的路径。这也说明 attention 权重可由端到端任务损失学习,无需每对词提供人工对齐标签。
3.8 把 2014 年当作开放选择
本节是完整保留的历史研究支线。当前主线先从同一给书句理解固定摘要与逐次读取;源序反转在此用于比较信息组织与学习条件,不承担“接下来一定要换attention”的必然结论。
先沿一对对应位置追踪依赖:源序为A、B、C,目标保持X、Y、Z;若关注A与X的对应,正序读完A后还需经过B、C的编码状态,才进入目标侧。将源序改为C、B、A后,同一源A紧邻编码结束处,目标X仍先生成。这一对早期对应的路径变短了,信息本身没有增多,目标也没有倒写。别的对应不必同样变短,所以不能从这一条图得出所有词对的平均距离都减少。
Sutskever等在深LSTM系统中试验了这种组织变化。同论文、单模型、beam=12的Table 1报告26.17与30.59 BLEU。原文用引入更多短期依赖解释优化改善;BLEU是任务结果,单靠它不能唯一证明内部机制。
相近时期的两条路线
Bahdanau初稿公开于2014-09-01,Sutskever初稿公开于2014-09-10。本课先讲固定摘要再讲动态读取,是概念依赖的组织,不能改写为前者看到后者已经发表才开始修补。
固定向量 encoder–decoder 是能工作的起点。Cho 等的 RNN Encoder–Decoder 用于短语评分,不能不加说明便当作同一个完整句子翻译实验。此处回看 Sutskever 与 Bahdanau 已公开的早期论文;课堂顺序不是实际研究者知悉对方工作的顺序。
| 论文内比较 | 系统与设置 | 全测试集 BLEU |
|---|---|---|
| Sutskever v1 Table 1 | 单模型,beam=12,源句正序 | 26.17 |
| 同上 | 单模型,beam=12,源句反转 | 30.59 |
后面将单独读Bahdanau的长度图与表格,两篇论文的数字不属于同一评价协议。Sutskever 的深 LSTM 与更大词表、不同训练及搜索设置不等于 Bahdanau 的基线。后者的 RNNsearch 使用双向编码器,每向 1000 单元,而 RNNenc 的编码器为 1000 单元,因而也不只是开关 attention 的消融。
Sutskever Figure 3 报告少于 35 词的句子没有性能下降,最长句仅轻微下降。这反驳“固定向量在长句上必然崩溃”的叙述,但不否定另一个设置下的瓶颈动机。Bahdanau Figure 2 在其设置中显示长度相关差别;图形趋势不应编造成未报告的精确分组数值。
源序反转说明,在不增加源信息的情况下,组织方式也能改变可学性。另一项值得研究的选择,是把整列源状态保留下来,允许每个目标位置重新读取;它与认真优化固定摘要的路线可以并行比较。
下一次比较尽量固定数据、分词、词表、训练预算、参数量、搜索与评测;单独控制编码方向。记录总 BLEU,也按长度、未知词与关系遗漏分组。若认真优化旧基线后动态读取优势消失,降低固定表示瓶颈解释的权重;若匹配条件后长距离关系和遗漏仍稳定改善,则增加这条路线的投入。以上是待实施实验,不是本课已经得到的训练结果。
反转证据直接约束了这个判断。若我们原先认定“固定向量装不下,所以必须换接口”,同一固定接口仅改变源序就取得改进,会要求把结论收窄。它支持继续认真优化旧路线,同时并不排除另一种访问方式可能更适合某些任务。值得比较的是在共同条件下能带来什么收益,而不是先把旧模型写成无效。
反转源句后要重新编码,目标顺序保持不变。部分早期对应的最短依赖间隔缩短,平均距离没有被证明全部缩短。这个成功的基线改动使后续问题更准确:动态读取相对一个认真优化的固定向量系统,在哪些任务与长度上值得增加复杂度?
3.9 从构造读取到真实对齐
把完整生成图中的每次读取保留下来,按目标生成顺序叠成八行,就从一条读取向量得到八行六列的对齐图。每一行仍沿同一组源位置归一化;例如her那一行可以回到此前对应的生成步骤。将这个表示方法带到真实论文图时,要重新读语言、横纵轴与明暗:Bahdanau原图白色表示较大权重,不应沿用另一张图的配色直觉。
翻译热图的横纵轴必须先读清:哪个是源词,哪个是目标词,一行是否对应一次归一化。近对角线可能表示大体顺序保持,偏移块可能对应词序交换,分散权重可能对应多个源位置共同参与。Bahdanau 的真实对齐例子见其 Figure 3。图显示这次计算的权重关系,却不是完整因果解释;value 大小、输出投影、残差以及其他层都影响最终预测。若要检验某个位置是否必要,需要定义干预、观察输出变化,并考虑干预是否把输入带离正常分布。
热图主要提供读取关系的观察。下面这张原论文结果图提供另一类证据:翻译质量怎样随句长变化。
Bahdanau 2014-09-01 v1物理第8页Table 1的All列中,RNNenc-50为17.82,RNNsearch-50为26.75。50表示训练句长上限;NoUNK列26.71/34.16只评价无未知词子集,延长训练28.45属于另一训练条件。All列支持动态读取路线的研究价值;双向编码和容量也改变,因此它不是等参数的attention单开关消融,更不能与Sutskever表格相减。
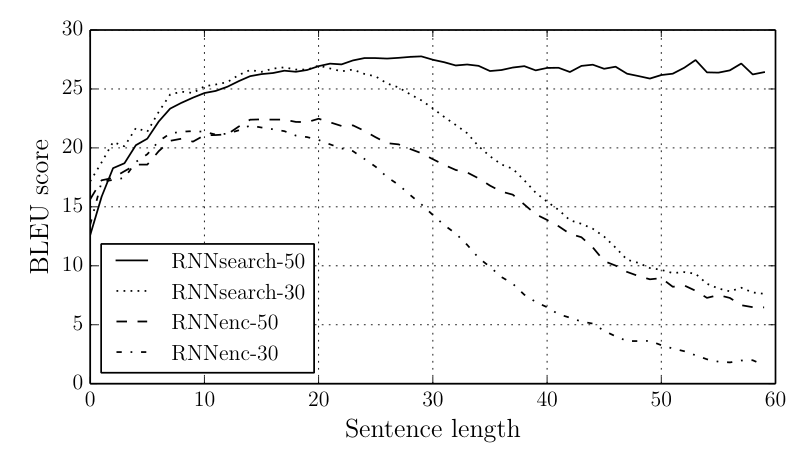
这张图来自 WMT 2014 英语到法语完整测试集,包含对模型而言有未知词的句子。30 与 50 表示训练时纳入的句子长度上限;RNNenc 是固定表示基线,RNNsearch 使用动态读取。图中 RNNsearch-50 在长句区域保持得较好,RNNsearch-30 到更长区域仍有下降。训练长度与结构都影响表现,不能只挑最高曲线便宣称 attention 无条件解决长句。
还要注意,RNNsearch 使用双向 encoder,每个方向各 1000 hidden units;基线 encoder 是 1000 hidden units,二者不是参数完全相等、只开关一个 attention 算子的消融。作者在相同数据与训练程序下的比较支持动态读取路线的价值,却不能单独隔离所有容量因素,更不能把当时的固定表示基线扩大成“所有 LSTM 都不能处理长句”。来源与条件见 Bahdanau 等,Figure 2、§4.1–4.2、§5.1。本图是原论文证据,未用生成图像改写曲线。
视觉 attention 使用的“位置”可以是图像局部特征。生成 dog 时强调含狗的区域是一种可以检查的现象,但人工画出的高亮只算教学示意;只有来自实际模型的权重才是模型测量。代表性原始工作见 Xu 等,Show, Attend and Tell,§3。
2016:机制怎样进入可用翻译系统
再读Google 2016年官方发布的同一中文新闻片段,四栏给出了源文、短语翻译、神经翻译与人工参考。可以沿源文的一处表达检查哪些信息被保留、哪些组织变得自然;这是该样例中的观察,不是产品总体排名。官方正文同时说明深层循环、attention和wordpiece等系统变化,让前面的计算机制有了实际系统位置。单个句子的改善并不足以唯一归因于某一个部件。Google 2016原发布与原图。
3.10 读到的改善与仍然失败的样本
另一个完整保留的合成反转实验中,固定摘要自由生成整句精确匹配为57.67%,动态读取87.00%,分母均为300条且包含EOS;单种子、共同500更新,动态组多1024参数。教师强制NLL与token准确率另按2016个有效token汇总。该比较支持这一任务上的接口价值,不证明自然翻译,更不把动态组剩余39条失败抹去。
这是把六字符词表 a–f 构成的序列反转的任务。输入 b d a d e,应得 e d a d b,实际却生成了 d e d a b。两条完整输出都还要以 EOS 结束;EOS也参加概率评分与整句核对。为什么整体指标进步了,这一句仍然错?
3.11 数据与计算预算是判断的一部分
两篇2014论文的质量结果还要放回各自训练预算。Sutskever2014-09-10 v1在选定WMT14英法12M句对上训练,源/目标词表160k/80k,四层1000cell、约380M参数,8GPU约一周。正文另报PPL5.8到4.7及BLEU25.9到30.6,与Table1分别保留口径。
Bahdanau2014-09-01 v1使用各30k词表,长度≤30/50训练,batch80、Adadelta;RNNsearch双向encoder每向1000,decoder1000。延长训练的28.45另列,不能与上表混成同预算结果。
可以把源序(正/反)与读取接口(固定摘要/逐位置读取)放进同一份小型翻译数据的四格设计,目标参考始终保持原顺序。每一列内只改变源序,保持编码方向、宽度、参数量、训练与搜索预算不变;跨列分别报告编码器配置和新增读取参数。它能研究源序效应及其与系统配置的交互;等容量控制是额外实验,四格本身不自动识别净attention因果效果。四格仍是待做研究设计,结果留空。 现有两组单种子合成反转共同500更新、动态组多1024有效参数,是机制相关的真实训练证据,不是自然翻译能力,也不能据此宣判那一句人称错译来自固定摘要。
假如更宽固定接口就追平,下一步可能继续优化旧系统;假如换搜索保留了正确候选却仍得低分,下一步就要查模型分布;如果动态读取只在一组长度有效,先查任务范围与随机性。这些结论都比预先写定“attention获胜”更有研究价值。
来源:Sutskever等v1、Bahdanau等v1,R7读本第二、三章,M15/M17/R4-2014/R5-JUDGMENT。历史结果来自原论文;本课合成结果来自存档checkpoint;四格为未执行设计。
3.12 一条已经失败的序列
这里切换到已经训练的合成序列反转任务。它不是her/him教学翻译;源序列、正确目标、实际输出与checkpoint身份在下表列出。动态组300条整句中仍有39条失败。当前真实样本检验模型排序是否偏好错序;后面的构造翻译将另示正确候选分数更高却未被搜索返回的情形。
| 对象 | 固定选择后的实际内容 |
|---|---|
| 源序列 | b d a d e |
| 应得(含结束符) | e d a d b <EOS> |
| greedy实际输出 | d e d a b <EOS> |
| 第一次分歧(从1计) | 1 |
这里使用DN1在Deepnote训练并保存的 dynamic-500.pt。按存档test顺序取第一条greedy失败的样本,得到从0计的索引25;没有为了让beam修好错误而另挑样本。DN2普通CPU只读重算,把同一对象的teacher forcing、自由生成与beam接起来。
训练/验证/测试3000/300/300,源长3–7,各集合源序列不重复。两组共享BiLSTM encoder与LSTM decoder设计、共同500次更新、各102417训练目标token;固定摘要15577参数,动态读取16601,多1024个query投影参数。没有多种子置信区间。
真实翻译也有条件输入、前缀和搜索,但可能存在多个合格译文、歧义、未知实体与复杂对齐;这里exact match的唯一目标不能替代翻译评价,更不能解释旧六片段诊断句“她→他”的全部原因。当前结果只支持这个受控合成任务上的比较。
3.13 同一格里,训练和生成看见什么
Teacher forcing:每步接入正确的历史。
| 步 | 真前缀 | 目标 | p(目标) | argmax |
|---|---|---|---|---|
| 1 | <BOS> | e | 0.327242 | d |
| 2 | <BOS> e | d | 0.990110 | d |
| 3 | <BOS> e d | a | 0.914952 | a |
| 4 | <BOS> e d a | d | 0.992090 | d |
| 5 | <BOS> e d a d | b | 0.982063 | b |
| 6 | <BOS> e d a d b | <EOS> | 0.962593 | <EOS> |
自由生成:每步接入自己已经选出的词。按同一步号对照上表,最后一列仍查询标准目标,而非所选词的概率。
| 步 | 自馈前缀 | 选词 | p(同位置标准目标) |
|---|---|---|---|
| 1 | <BOS> | d | 0.327242 |
| 2 | <BOS> d | e | 0.000236 |
| 3 | <BOS> d e | d | 0.134230 |
| 4 | <BOS> d e d | a | 0.001531 |
| 5 | <BOS> d e d a | b | 0.997601 |
| 6 | <BOS> d e d a b | <EOS> | 0.855428 |
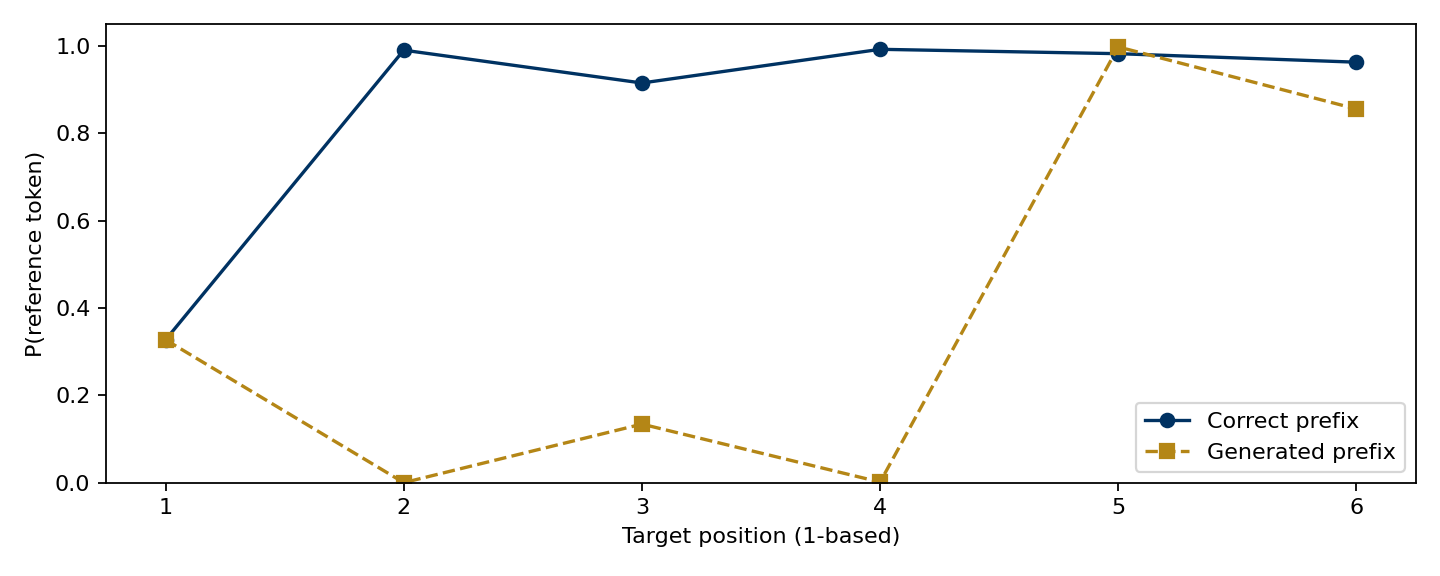
图中横轴是目标位置;两线都取该位置标准目标的概率,条件前缀分别来自标准答案与实际生成,曲线不是两次新训练。
第一次分歧发生在第1步,此时两种路径都还只有BOS作为decoder输入,所以不能把第一步错误归因于先前自馈错误积累。模型已给d比正确e更高的概率。第2步开始,teacher forcing接回正确e,自由生成接回自己选出的d,两个条件分布不再相同。此后出现错位,并不能只靠观察一句输出判定是状态信息不足、读取错位还是前缀分布变化。
在这个实现中动态读取的初始h为0,query投影无bias,第一步对所有有效源位置均匀读取;encoder状态仍可能携带足够信息,所以“均匀”本身不等于必然失败。它提出一个可检验假设:初始化/读取时序可能影响首词。另一个解释是当前模型对这个排列训练不足。比较同长度样本的首词错误分布、检查首步表示,再做受控初始化训练,才能区分;这些初始化训练仍是待做对照。
3.14 指标变好没有承诺每一句都对
| 模型 | TF平均NLL | TF token正确率 | 自由生成exact match |
|---|---|---|---|
| fixed | 0.287898 | 90.9722% | 57.67% |
| dynamic | 0.106673 | 97.7679% | 87.00% |
NLL和token accuracy在正确前缀下按2016个有效目标token(含EOS、排除PAD)汇总;exact match在自由生成下按300条完整样本算。它们不是同一分母,也不是同一种输入条件。动态组总体更好,却仍有39条整句失败。这条样本让平均进步与局部失败同时变得具体:不需要用“attention更强”来掩盖错误。
正确答案的整句log概率可直接将teacher-forced各目标的log p相加;对候选句也用它自己的前缀逐步计分。它是概率模型的排序,不是教师对忠实性的判分。
3.15 beam有没有把正确答案漏掉
| 宽度 | 最高分完成序列 | 累计log p(含EOS) | exact match |
|---|---|---|---|
| 1 | d e d a b <EOS> | -0.905535 | False |
| 2 | d e d a b <EOS> | -0.905535 | False |
| 4 | d e d a b <EOS> | -0.905535 | False |
同一正确序列的teacher-forced累计log p = -1.280045。beam2最后一轮确实保留了这条正确完成项,仍把错误项排在前面。
beam2已经把正确序列保留到了结束,但它的分数低于错误序列,所以加宽到4仍选错。这个观察削弱“只是beam太窄漏掉正确路径”的解释;它没有证明已找到全词表所有可能句子的全局最优。它还表明在这条样本上,搜索更忠实地执行当前分数,不一定让任务更正确。可检查的是模型排序为何偏好错序,而不是继续机械增加beam。
表中数值是DN2本地CPU参考重算;Deepnote同一checkpoint的云端保存输出中,错误完成项为−0.905534469,本地为−0.905535110,相差约6.41×10⁻⁷。环境与浮点运算顺序会造成末位差别;样本、首错与候选排序一致,不能要求逐位相同。
旧扩展概率树是另一种身份:人为规定归一化边概率,用来展示局部选择与整句分数分离;不要把树上的A/B概率当成这次checkpoint输出。真实模型中EOS完成项占beam名额,累计log p含EOS、无长度惩罚;Sutskever原论文的完成集合管理不同,不宣称逐行复刻。
3.16 同样的错译,先检查一项能区分解释的证据
源句仍为 我/昨天/给了/她/一本/书。把 her 误写为 him,可能是源表示没有保留角色、读取或训练不足、模型偏好错误,也可能是搜索没有返回模型评分更高的正确句子。不能仅从一个错词选定根因。
现在额外给定两条教学构造的候选评分:同源、同模型参数、同tokenizer,八项目标含句号与EOS,自然对数求和,不加长度惩罚。
| 候选 | Σlog p | 是否返回 |
|---|---|---|
| I gave him a book yesterday . EOS | −8.2 | 是 |
| I gave her a book yesterday . EOS | −6.4 | 否 |
−6.4高于−8.2,因而至少存在这一对候选的搜索遗漏。下一步优先记录候选覆盖和beam剪枝,或在短序列受限词表中穷举。这个证据没有证明her是全空间最高分,也没有证明其他源信息都用对。反过来,若正确句已被保留但分数较低,扩大搜索本身不能改变模型对这一对的排序。前面§3.12–3.15的真实反转样本提供了后一种情形,两项诊断各自适用于各自案例。
3.17 一个小概率树:局部最大不等于整句最大
需要暂时换成A/B/C,是为了隔离搜索这一部件,而不声称已测得某个词的真实翻译概率。固定参数和源条件后,模型分布可以视为给定;搜索器的责任是按这份分布找到或采样完整后续。只要在一棵可穷举的小树里看到局部选择错过整条高分路径,就知道“输出错了”不能直接定位到编码接口。
沿用完整保留的旧扩展有限概率树,暂用抽象 token 研究搜索,避免把字母误当正确译词。第一步分布为 A:0.45、B:0.30、C:0.25。A 后是 a:0.70、b:0.30;Aa 后是 EOS:2/3、c:1/3;Aac 与 Ab 后都必然 EOS。B 后是 EOS:0.75、d:0.25;Bd 后必然 EOS;C 后必然 EOS。未列出的后继概率为零。
| 完整后续 | 路径乘积 | 概率 |
|---|---|---|
| A a EOS | $0.45\times0.70\times2/3$ | 0.210 |
| A a c EOS | $0.45\times0.70\times1/3$ | 0.105 |
| A b EOS | $0.45\times0.30$ | 0.135 |
| B EOS | $0.30\times0.75$ | 0.225 |
| B d EOS | $0.30\times0.25$ | 0.075 |
| C EOS | $0.25$ | 0.250 |
所有完整路径的概率和为 1。Greedy 首步选 A,随后选 a、EOS,概率为 0.210;穷举可见 C EOS 的 0.250 才是最大值。首步较大的前缀概率,还要乘以之后的条件概率,不能预先当作完整序列分数。
宽度为 2 的 beam 首轮保留 A 与 B,已经丢掉 C。约定已结束项仍占 beam 名额且不再展开,第二轮从 Aa .315、B EOS .225、Ab .135、Bd .075 中保留前两项;第三轮保留 B EOS .225 与 Aa EOS .210,返回 .225。它优于本例 greedy,却仍低于被剪掉的 .250。有限 beam 是近似搜索;扩大搜索预算找到更高模型概率,也不自动提高翻译忠实度,因为模型分布本身还可能有偏差。
3.18 可实施的 beam、结束符与长度处理
序列分数通常用对数概率相加,避免许多小数相乘下溢。因为每个条件概率不大于 1,追加 token 的原始 log score 不会增加,因此不同长度间会有短输出偏好。EOS 的概率是模型的一部分,不能在比较时省略。长度惩罚则另外改变排序目标;它是解码启发式,不再是严格寻找最大概率序列。
下面给出与旧扩展树一致的完整教学 beam 控制循环。next_log_probs(prefix) 负责返回合法后继的 log 概率;已结束序列保留在 beam 中,不继续展开。每轮与最终排序使用同一个 rank 函数。长度定义为不含 EOS 的目标 token 数,标点仍计入。$\alpha=0$ 就是原始 log 概率排序。
def beam_decode(next_log_probs, width=2, max_steps=32, alpha=0.0):
    if width < 1 or max_steps < 1:
        raise ValueError("width and max_steps must be positive")
    def rank(item):
        seq, log_p = item
        length = len(seq) - int(bool(seq) and seq[-1] == "EOS")
        penalty = ((5.0 + max(1, length)) / 6.0) ** alpha
        return log_p / penalty

    beams = [((), 0.0)]
    for _ in range(max_steps):
        candidates = []
        for prefix, score in beams:
            if prefix and prefix[-1] == "EOS":
                candidates.append((prefix, score))
                continue
            for token, log_p in next_log_probs(prefix).items():
                candidates.append((prefix + (token,), score + float(log_p)))
        if not candidates:
            raise ValueError("No legal successor")
        beams = sorted(candidates, key=lambda z: (-rank(z), z[0]))[:width]
        if all(seq[-1] == "EOS" for seq, _ in beams):
            break
    finished = [item for item in beams if item[0][-1] == "EOS"]
    pool = finished if finished else beams
    best = max(pool, key=rank)
    return {"tokens": best[0], "log_probability": best[1],
            "rank_score": rank(best), "ended": best[0][-1] == "EOS"}
实际使用还需处理 PAD/BOS 禁止输出及批量缓存重排等工程条件。ended=False 明确表示达到上限却没有 EOS,不能冒充完整结束。本程序让完成项占 beam 名额;另一类实现把完成项另存、只对活跃项限制宽度,可能走出不同结果。Sutskever 等的原实现采用独立完成集合,不能与这个独立手工约定混用。若想在仍有活跃项时提前停止,需要与评分目标相容的上界;凑满若干 EOS 本身不是证明。长度惩罚的常见工程形式见 Wu 等,Google's Neural Machine Translation System,§7。
3.19 BLEU 到底计算了什么
BLEU 衡量候选译文与参考译文的 n-gram 重合。修改过的精确率会剪裁重复计数:候选某 n-gram 出现十次,参考只出现一次,不能得十分。对每个阶数 $n$,先在整套评价语料汇总剪裁后的匹配数和候选 n-gram 总数,得到 $p_n$,再计算
$$\mathrm{BLEU}=\mathrm{BP}\exp\left(\sum_{n=1}^{N}w_n\log p_n\right),\qquad \mathrm{BP}=\begin{cases}1&c>r,\\ \exp(1-r/c)&0<c\le r.\end{cases}$$
$c$ 是候选总长度,$r$ 是按规定选择的参考长度总和。空候选单独记为零分。常见 BLEU-4 取四阶等权;这里用 BLEU-2 展示可手算机制。参考为“I gave her a book yesterday”,候选为“I gave a book yesterday”,均保留大小写、移除句末标点。候选的五个 unigram 全匹配,$p_1=5/5=1$;四个 bigram 为 I gave、gave a、a book、book yesterday,其中三个匹配,$p_2=3/4$。候选长 5,参考长 6,故
$$\mathrm{BLEU}_2=e^{-0.2}\sqrt{3/4}\approx0.7090,$$
按百分制约为 70.90。这个高分候选漏掉了接受者 her,正好暴露局部重合与忠实性之间的差别。若候选只有“the the the”,unigram 计数也必须按参考里 the 的出现次数剪裁,不能靠重复提高得分。原始定义见 Papineni 等,BLEU,§2。
单句很短时,高阶 n-gram 可能完全不匹配,使未平滑 BLEU 变成零;不同平滑方法会给不同值。语料 BLEU 不是先算每句 BLEU 再取平均。分词、大小写、参考数、平滑和实现版本都需要记录。BLEU 适合比较固定条件下的系统,却不能判断所有同义改写,更不单独证明事实或语义正确。实验 D 同时看精确序列匹配、任务字段正确率和完整输出,会比只看一个分数更有解释力。
3.20 从这里提问,再回到同一个对象
你可以把本主题URL交给Agent,用自己的话描述:“它已经把正确顺序留在候选里了,为什么还选错?”上下文应包含这条源/目标、checkpoint身份和上述分数,而不是只贴87%。Agent能据正文区分搜索、概率和任务正确性;若讨论你的私人运行,需要你另附参数和输出。
回到LAB02的“路径A · 分数进步了,为什么这一句仍然错”,运行下面的只读检查;它重新按固定规则取样,不覆盖参考文件。把beam宽度改为已有1/2/4中的另一值,核对正确路径是否出现、它的累计分数与第一分歧。返回判断应是“这个checkpoint的这个样本不因当前beam加宽而修好”,不是“beam永远没用”或“所有错误都来自exposure bias”。
import learning_paths as paths
A = paths.path_a(ROOT)
print(A['test_index'], A['source'], A['target'], A['greedy'])
display(pd.DataFrame(A['teacher_forced']))
display(pd.DataFrame(A['free_trace']))
print({w:(x['tokens'], x['log_probability']) for w,x in A['beam'].items()})
beam_width = 2  # 可选1、2、4;结果对象的键是字符串
display(pd.DataFrame(A['beam'][str(beam_width)]['trace'][-1]))
3.21 复核与实现
| 复核项 | 身份 |
|---|---|
| 存档test索引(从0计) | 25 |
| checkpoint | dynamic-500.pt |
| SHA256 | 67ffebe93c8072e23b65a03b3ded8c6eabd18bff5701986f36747842d7634b38 |
| 结果身份 | DN2本地CPU只读重算;云端保存输出的末位差异见beam段 |
下面是与上述检查同源的诊断函数:包括固定取样、加载权重、两种前缀与beam。它读取参考文件;结果写入由LAB的独立输出目录管理。
@torch.no_grad()
def path_a(root):
    root=Path(root);p=root/'results/cloud/seq2seq'
    models,data,report=seq.load_pair(p)
    rows=data['test'];model=models['dynamic'];pred,_,_=seq.greedy(model,rows)
    # Rule fixed before inspecting the selected answer.
    idx=next(i for i,r in enumerate(rows) if pred[i]!=r['target']);row=rows[idx]
    src,l,di,y=seq.batch([row]);logits,_=model(src,l,di);lp=logits.log_softmax(-1)[0]
    free=pred[idx];first=next(i for i,(a,b) in enumerate(zip(free,row['target'])) if a!=b)
    z,mask=model.encode(src,l);state=model.initial(1);token=torch.tensor([seq.BOS]);trace=[];prefix=[]
    for t in range(max(12,len(row['target'])+2)):
        out,state,weights=model.step(token,state,z,mask);prob=out.softmax(-1)[0];chosen=int(prob.argmax())
        trace.append({'step_one_based':t+1,'input_prefix':[seq.VOCAB[seq.BOS]]+[seq.VOCAB[x] for x in prefix],
                      'chosen':seq.VOCAB[chosen],'p_chosen':float(prob[chosen]),
                      'p_reference_here':float(prob[row['target'][t]]) if t<len(row['target']) else None,
                      'reference':seq.VOCAB[row['target'][t]] if t<len(row['target']) else None,
                      'source_weights':weights[0].tolist()})
        prefix.append(chosen);token=torch.tensor([chosen])
        if chosen==seq.EOS:break
    tf=[{'step_one_based':t+1,'input_prefix':[seq.VOCAB[seq.BOS]]+[seq.VOCAB[x] for x in row['target'][:t]],
         'target':seq.VOCAB[tok],'argmax':seq.VOCAB[int(lp[t].argmax())],
         'p_target':float(lp[t,tok].exp()),'nll':float(-lp[t,tok])} for t,tok in enumerate(row['target'])]
    metrics={}
    for name,m in models.items():
        nll=correct=count=0
        for i in range(0,len(rows),32):
            s,ll,dd,yy=seq.batch(rows[i:i+32]);oo,_=m(s,ll,dd);valid=yy!=seq.PAD
            nll+=float(torch.nn.functional.cross_entropy(oo.flatten(0,1),yy.flatten(),ignore_index=seq.PAD,reduction='sum'))
            correct+=int(((oo.argmax(-1)==yy)&valid).sum());count+=int(valid.sum())
        pp,_,_=seq.greedy(m,rows)
        metrics[name]={'teacher_forced_nll':nll/count,'teacher_forced_token_accuracy':correct/count,
                       'free_generation_exact_match':sum(a==b['target'] for a,b in zip(pp,rows))/len(rows),'valid_tokens':count}
    return {'identity':'DN2 local CPU read-only reevaluation of DN1 cloud checkpoints; no retraining',
            'selection_rule':'first dynamic greedy failure in stored test order, zero-based index',
            'test_index':idx,'source':[seq.VOCAB[x] for x in row['source']],
            'target':[seq.VOCAB[x] for x in row['target']], 'greedy':[seq.VOCAB[x] for x in free],
            'first_divergence_one_based':first+1,'teacher_forced':tf,'free_trace':trace,
            'beam':{str(w):seq.beam(model,row,w) for w in [1,2,4]},'metrics':metrics,
            'config':model.config,'checkpoint_sha256':{n:hashlib.sha256((p/f'{n}-500.pt').read_bytes()).hexdigest() for n in models},
            'data_sha256':hashlib.sha256((p/'data.json').read_bytes()).hexdigest()}
来源:LAB02存档results/cloud/seq2seq的data.json与fixed/dynamic-500.pt;正文结果与哈希同源导出,完整JSON附在主题入口。训练背景见R7读本第二、三章与Seq2Seq2014 v1。模型诊断是DN2只读重算,历史57.67%/87.00%训练身份保留。
3.22 下一项选择还要保留什么反证
构造her/him评分支持先查搜索遗漏;真实反转样本中正确完成项在beam2里却得分更低,支持先查模型排序、BOS首步读取/初始化与训练。改变的是当前样本的优先诊断,没有撤销另一案例已成立的结论。动态读取增加了通路,编码源表示的RNN仍然逐步运行。接下来要问:若源侧各位置直接交换信息,循环原先承担的顺序、状态与计算职责由谁来完成?
第四章 丢掉循环以后,原有职责谁来承担
动态读取仍可建立在逐步编码的RNN上。若希望已知源位置并行形成表示,就需要认真比较循环、卷积与self-attention,并补上顺序、合法目标边界和完整单元。最后用2017年当时可见的质量与资源结果决定投入。
4.1 从九行读取走到完整翻译器
改用Transformer时,从九个源单位的 embedding 重新建立表示,不能把旧RNN已经算好的 $h_1,\ldots,h_9$ 当成新模型的原始输入。先选“给”这一行:它的query读取各个源位置的key/value,形成属于“给”的输出;再选“他”这一行,保留前一行,另得属于“他”的输出。九个位置都做一次,分数与权重才是9×9,输出仍保留九行。
按行放输入 $X\in\mathbb R^{9\times d}$,同一组共享投影得到 $Q=XW^Q,K=XW^K,V=XW^V$。每个query都对九个来源归一化:$A=\operatorname{softmax}_{key}(QK^\top/\sqrt{d_k})$,$Y=AV$。softmax不沿query轴;所有行也不会被平均为一个句子向量。点积先形成分数,再除以 $\sqrt{d_k}$,最后softmax;不能先归一化再缩放概率。
若无位置、全可见且逐位置共享投影,将输入九行中的我与他交换,输出也按同一置换交换。以P表示置换,$Q'=PQ,K'=PK,V'=PV$,最终 $Y'=PY$,这是等变而非整张输出逐格不变。然而“我给他”与“他给我”关系不同。恢复原句后令第i行输入为 $E[x_i]+p_i$,token交换而位置向量留在各自位置,模型就能把内容与顺序共同用于计算。带固定因果mask时任意置换还改变可见集合,不能照搬全可见推导。
完整翻译模型有独立的源encoder和目标decoder。九行源embedding加位置,经过encoder后形成源矩阵H;目标输入是右移后的BOS、I、gave、him、a、book、yesterday、句号。源端已收到全部中文,所以可读取全源;gave目标行要预测him,只能读取BOS、I、gave三项目标输入,包括自己。
Encoder每层的多头self-attention把不同来源混入各位置,再经残差与LayerNorm;逐位置FFN把每行通道非线性变换,最后再作残差与LayerNorm。以2017的post-norm写为 $U=\operatorname{LN}_1(X+\operatorname{MHA}(X))$,$Z=\operatorname{LN}_2(U+\operatorname{FFN}(U))$。两个head有各自投影;在同一token位置拼接两头输出,再经 $W^O$ 回到模型宽度。残差是逐元素相加,LayerNorm在单一token的特征轴上计算,不跨句子位置。
FFN可用4→6→4的小尺寸看清扩展、ReLU与投回,所有位置共用同一组参数,但每行独立计算。它不会再直接读取另一个token;上下文已由attention进入这行。$U_i$表示第i个token的整行,$U_{i,r}$才表示第r个通道。下文保留的旧三行、两头数值BLOCK有完整矩阵与代码,独立于当前九单位图;新图解释部件职责,下文从头给出旧算例的每一项数值。
Decoder每层则有三个子层:目标masked self-attention、读取源H的cross-attention、逐位置FFN,各自带残差和归一化。第一种Q/K/V均来自目标表示;第二种Q来自当前目标子层,K/V来自encoder最终H。不能删掉cross-attention以后仍把图叫作同一个源目标分离的翻译器。
最后decoder表示经词表头得到him的概率。选中him才把它回送,随后生成a、book、yesterday、句号与EOS。训练已知全部右移输入,可在每层同时计算各位置的合法条件概率;自由生成的未来词尚未确定,仍逐步追加。这些依赖与可并行范围是结构事实,翻译质量和速度优势需要在2017当时的数据、预算和硬件条件下判断。
下面的历史计算图、bank语境、旧六片段矩阵与完整BLOCK为独立扩展。九单位源的读取与合法目标边界已在上面接通;不得将旧矩阵的小数当成新九单位网络的实测。
2017 年 6 月回看,强循环路线 GNMT 已使用 attention,ConvS2S 也把卷积与 attention 结合起来。架构选择不是“旧方法没有 attention、新方法才有”;改变的是序列计算骨架。普通局部卷积同层可并行,远距影响须经层叠;膨胀卷积的路径口径另计。先追远处信息经过的连接,再检查可并行步骤和代价。
RNN 每步依赖上一状态,处理长度 $n$ 的序列时有 $n$ 个时间依赖步骤。局部卷积可在一层并行处理各位置,但远处信息通常要经过多层或扩大感受野。全 self-attention 让任意两位置在一个子层内建立直接连接,并让同层各 query 并行计算;代价是要处理随长度平方增长的成对交互。
若宽度为 $d$,仅看典型层级数量级,RNN 的循环变换约为 $O(nd^2)$;全 attention 的成对乘法约为 $O(n^2d)$,还要加 $O(nd^2)$ 的投影。比较不能只看 $n$ 或只说某一种全面更快:长度、宽度、设备、并行实现和任务所需的连接都影响实际选择。2017 年的贡献也不只是减少理论路径,而是给出完整可训练结构与翻译实验。Vaswani 等,§4、Table 1。
4.2 回到 bank:同句上下文成为读取来源
bank两句是另一个独立语境比较,解释上下文化的用途。本章开头以给书句的给行、他行和九行self-attention说明这一接口。
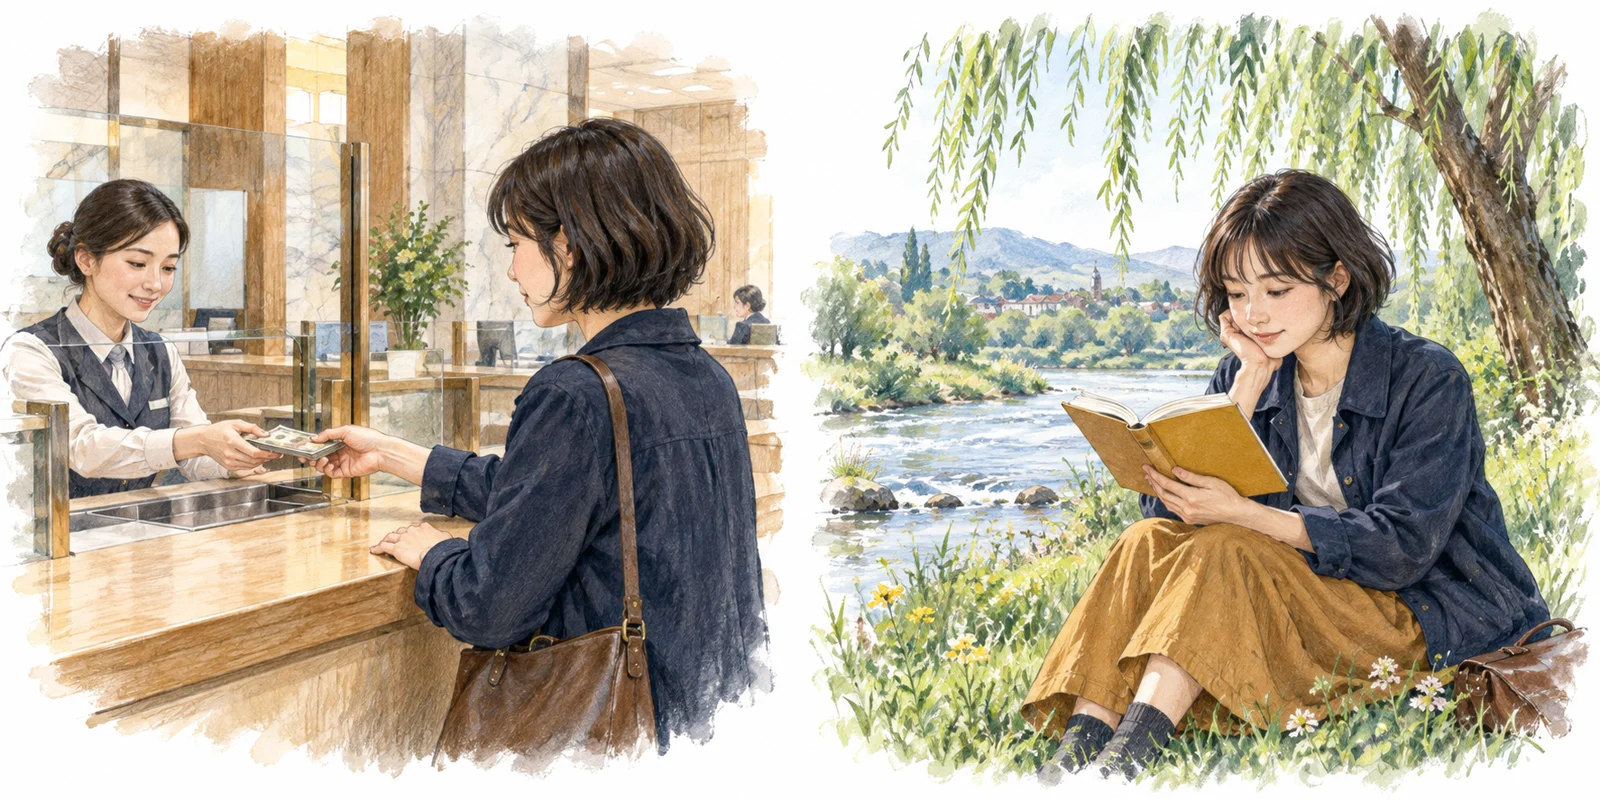
图为本讲生成的情境插图,用于人的观察比较,不是模型预测。
看两条教学例句:“She deposited money at the bank.”与“She sat on the bank of the river.”。读者借助 money、deposited、river 区分银行和河岸。如果 tokenizer 把两处 bank 编成同一个 ID,那么固定 embedding 查表会返回同一行;区别可以在后续使用上下文的网络中形成:
$$h_t=f_\theta(x_1,\ldots,x_n;t).$$
这里的关键区别是:我们已经凭money与river作出不同判断,但查表没有读取这些邻词。需要改变的是从初始向量到本次表示的计算,而不一定是给bank分配两个固定词表地址。同样,两个不同的随机输出也不等于消歧正确;要让这种差异有意义,后面必须给出训练目标与独立检验。
$x_t$ 是词类型的初始表示,$h_t$ 是该词本次出现的上下文化表示。RNN、窗口网络、Transformer 都能以不同方式实现 $f_\theta$。情境插图使人看清两个场景,但没有模型实测时,不能把读者的判断当作网络已经消歧的证据。
两次E[bank]相同;窗口网络与 RNN 已能产生上下文组合,self-attention 改变的是访问与组合方式,不能称为第一次出现上下文表示。先选各句 bank 作为 query,读取本句所有可读位置并留下 h_bank;再把银行句的 query 换成 money、河岸句换成 river,保留原输出并新增各自的 h_money、h_river。图中的等样式连接与语境高亮只说明可能的信息路径和输出位置,不代表训练权重或已经完成的消歧。
不能在bank读完之后把整句话压成唯一一个新向量。bank的读取结果属于bank;money也可以提出自己的需求,并获得自己的输出。把各个位置的输出都保留下来,才得到后续网络能够继续处理的一组上下文化表示。初始E[bank]仍相同,但每句可读的来源不同,这给本次表示不同提供了计算通路;是否形成正确消歧仍需训练和检验。
Cross-attention 的 query 来自目标侧,K/V 来自另一组源表示,通常 $m\ne n$。Self-attention 的 Q/K/V 从同一组输入分别投影,通常 $m=n$,但每个位置得到自己的输出,并非整句只能产生一个向量。“self”说明信息来源,“causal”说明可见连接;二者不是同一个概念。
4.3 两次读取并列成矩阵
以下2×3及6×6图保留旧R7.1的数学身份,六个源片段是“我/昨天/给了/她/一本/书”。它们供独立复算,不是新九单位图的缩略运行。
多个位置各自完成同一种读取,不必只在纸上画许多份公式。把需求逐行摆放,一行对应一项query;把来源逐行摆放,一行对应一个key/value,便能一次计算所有配对。矩阵化保留每项需求的身份,没有把它们平均成一个问题。
从这里开始恢复按行存 token 的约定。$Q\in\mathbb R^{m\times d_k}$ 有 $m$ 个 query;$K\in\mathbb R^{n\times d_k}$、$V\in\mathbb R^{n\times d_v}$ 有 $n$ 个可读取位置。于是
$$S=QK^\top/\sqrt{d_k}\in\mathbb R^{m\times n},\qquad A=\operatorname{softmax}_{\mathrm{key}}(S+M),\qquad Y=AV\in\mathbb R^{m\times d_v}.$$
第 $i$ 行对应第 $i$ 个 query,第 $j$ 列对应第 $j$ 个 key;softmax 沿列、也就是 key 轴归一化。$A_{ij}$ 表示 query $i$ 读取位置 $j$ 的权重。把单个 query 重复计算 $m$ 次,与一次矩阵乘法组织起来,在同样 mask 和数值条件下表达的是同一计算。
先把第三章的未缩放读取并成两行:
$$Q=\begin{bmatrix}1&0\\0&1\end{bmatrix},\quad K^\top=\begin{bmatrix}1&0&1\\0&1&1\end{bmatrix},\quad V=\begin{bmatrix}2&0\\0&4\\1&2\end{bmatrix}.$$
$$QK^\top=\begin{bmatrix}1&0&1\\0&1&1\end{bmatrix},\quad A\approx\begin{bmatrix}.422319&.155362&.422319\\.155362&.422319&.422319\end{bmatrix},\quad AV\approx\begin{bmatrix}1.266956&1.466087\\.733044&2.533913\end{bmatrix}.$$
这里的两行分别是query 1与query 2,三列是三个源位置;V与输出的列都是特征轴。两个输出保留各自需求的身份。它是2×3的局部读取,不是完整self-attention。若六个源位置全部产生Q、K、V,每个位置都作为一行query,分数表就是6×6,行列都对应“我/昨天/给了/她/一本/书”;输出仍有六行。
这组精确值使用未缩放点积。改用2017的scaled dot product时,先对分数除以√d_k,再做softmax:d_k=2时,得分1变成1/√2≈.707107,得分0仍为0,权重随之改变。前面的(.422319,.155362,.422319)因此只属于未缩放条件;后面的多头block会使用缩放条件。
批量多头时可以写成 $Q:[B,H,m,d_k]$、$K:[B,H,n,d_k]$、$V:[B,H,n,d_v]$。仅交换 K 最后两维得到分数 $[B,H,m,n]$,softmax 仍沿最后一维,输出 $[B,H,m,d_v]$。不能把整个四维张量任意转置,也不能误沿 query 轴归一化。
4.4 回到 attention:控制分数尺度
若 $q$、$k$ 的分量近似独立、零均值、单位方差,点积 $\sum_{r=1}^{d_k}q_rk_r$ 的方差为 $d_k$。维度变大时,logits 尺度容易变大,softmax 可能过于尖锐。除以 $\sqrt{d_k}$ 使这个近似条件下的方差保持约为 1。真实网络不必严格满足独立假设,因此这是解释缩放作用的近似论证,不是对所有层的分布定理。注意前提是零均值,不是单位均值。Vaswani 等,§3.2.1。
Softmax 自身是非线性,而且权重随输入改变。因此“attention 没有非线性,才需要 FFN”不准确。FFN 另有关键分工:在每个位置内部做非线性通道变换。Attention 主要提供跨位置的信息混合;两者会在完整 block 中配合。
4.5 重排一次,再让位置进入计算
本节旧三行置换数值与下面的旧“她”句是独立证明练习;当前九行的我/他实际交换与固定位置恢复见本章开头。
去掉递推以后,有两个原来容易被计算顺序遮住的问题。第一,输入排列是否仍能影响关系;第二,目标位置是否会提前读到答案。位置表示回答前一个,因果mask与目标移位回答后一个。它们不是同一种装饰,也不能相互替代。
把同一组输入行实际按“第3行、第1行、第2行”重排。无位置、全可见、各位置共享投影时,原第3行的query与它面对的key/value只是一起换了地址,仍汇总同样的内容;所以输出也按“第3行、第1行、第2行”重排。观察的是对应行的数值保持与地址变化,不是整张输出逐格保持不变。
若没有任何位置信号、使用全 attention,且相同投影逐位置共享,重排输入只会相应重排输出。令 $P$ 为置换矩阵,则 $Q'=PQ$、$K'=PK$、$V'=PV$,分数变为 $PSP^\top$;逐行 softmax 后也只重排行列,最终 $Y'=PY$。这叫置换等变,不是置换不变。若再用顺序无关的平均池化,整体分类结果才可能对这种重排不变。
“我给她书”和“她给我书”具有不同关系,模型因此需要知道 token 所处的位置。绝对位置的一种办法是给每个位置一个向量 $p_i$,计算 $X_i=E[x_i]+p_i$。原始 Transformer 使用正弦余弦式,并比较了学习位置向量:
$$\mathrm{PE}(p,2r)=\sin\left(p/10000^{2r/d}\right),\qquad \mathrm{PE}(p,2r+1)=\cos\left(p/10000^{2r/d}\right).$$
不同频率提供不同尺度的位置变化。原始模型还对 token embedding 乘以 $\sqrt d$,再与位置表示相加。能用公式计算超过训练范围的位置,不等于模型在更长序列上的利用能力已得到验证。若用固定 causal mask,任意重排会改变每个位置的可见关系,上述“全 attention 无位置”的等变推导不能原封不动套用。
位置还可以采用相对表示,RoPE等后续变化在第五章的现代部件中完整展开。这里先把顺序表示接回2017的完整模型。
4.6 对齐输入与目标,确定合法读取
以下her标签属于保留的旧六片段翻译示例。当前主线对应gave输入行预测him,规则完全相同,具体标签与源长度分开。
采用加性 mask:允许连接为 0,禁止连接为 $-\infty$,先加到分数再 softmax。三个目标输入位置的 causal mask 为
$$M=\begin{bmatrix}0&-\infty&-\infty\\0&0&-\infty\\0&0&0\end{bmatrix}.$$
行是 query,列是 key,故未来位置在右上角被遮住。对角线允许读取自己,因为位置上的输入是用来预测下一 token 的。例子中输入为 BOS、I、gave 时,gave 这一行预测 her,可以看到 gave;若标签没有正确移位,同样的 mask 也救不了答案泄漏。
Padding mask 禁止读取补齐出来的 key,cross-attention 中也要屏蔽源句的 padding。若一个 query 行所有 key 都被遮住,softmax 的数值定义会出问题;实现应避免为有效 query 制造这种行,或为无效 padding query 明确约定零输出并排除损失。把屏蔽后的权重直接设为零却不重新归一化,会改变输出尺度,不等价于正确的 masked softmax。
4.7 先看完整翻译器,再放大一个 block
以下整机图保留R7.1六片段她/her情境作为扩展。当前九单位整机见本章前面的T30与T32;两者共用架构原则,没有共用自然翻译实测成绩。
完整系统先分成两侧。源句六个位置查embedding并加入位置,经过多层encoder,形成逐位置源表示。目标端把参考译文右移为BOS、I、gave、her……;每层先做masked self-attention,再用cross-attention读取完整源表示,最后做FFN。三个子层各有自己的残差与归一化,随后才进入下一层。最后的目标表示投影到词表;gave输入行对应her标签。
源端已经收到整句中文,可以双向读取所有有效源位置;目标端未来词还不能参加当前位置预测。cross-attention的Q来自目标当前子层,K/V来自encoder最终输出。这张完整图把同句读取、跨序列读取和任务头分开。下文放大encoder的一个全可见post-norm block,逐项核算,再回到本图解释decoder多出的cross-attention。
旧的最小causal语言模型例仍可作为局部对照:若暂省多头、残差、归一化、dropout与层叠,$X=E[x]+P$,$H=\mathrm{softmax}_{key}(QK^\top/\sqrt{d_k}+M)V$,$Z=\mathrm{FFN}(H)$,$p_i=\mathrm{softmax}_{vocab}(Z_iW_{vocab}+b)$。它只定义$p(y_i\mid y_{<i})$;完整翻译器通过encoder条件定义$p(y_i\mid y_{<i},x_{src})$。两个系统可以比较部件职责,不能借用同一次运行的概率。
4.8 两个 head 怎样投影、读取与合并
下面三节完整保留旧BLOCK的两路读取、拼接与输出投影,展开同一个全可见 post-norm 局部 block 算例,共享输入 X 与全部投影,供独立复算。第一位置也读取后两行;它与因果目标侧只作算子对应,数值不能直接贴回只读自身的目标第一行。
设按行存储的输入 $X\in\mathbb R^{n\times d}$。第 $r$ 个 head 有自己的参数
$$Q_r=XW_r^Q,\quad K_r=XW_r^K,\quad V_r=XW_r^V,$$ $$H_r=\operatorname{softmax}\left(Q_rK_r^\top/\sqrt{d_k}+M\right)V_r.$$
$W_r^Q,W_r^K\in\mathbb R^{d\times d_k}$,$W_r^V\in\mathbb R^{d\times d_v}$。不同 head 可以在不同投影空间计算匹配与内容;不是把完全相同的一张注意力矩阵复制几遍。然后
$$\operatorname{MHA}(X)=\operatorname{Concat}(H_1,\ldots,H_H)W^O,$$
其中拼接结果为 $n\times(Hd_v)$,$W^O\in\mathbb R^{Hd_v\times d}$,输出回到 $n\times d$,才可以与 X 相加。Q/K/V 随输入变化,投影矩阵是训练参数。Cross-attention 只把 Q 的输入换成目标侧表示,K/V 的输入换成 encoder 输出;维度规则相同。
取一个可复算的两头例子:$d=4$,$H=2$,$d_k=d_v=2$,
$$X=\begin{bmatrix}1&0&1&0\\0&1&0&2\\1&1&0&1\end{bmatrix}.$$
三行对应旧独立BLOCK选取的“我、给、书”位置,数值为未训练构造。第一头 Q/K 取输入前两维,V 取后两维;第二头 Q 取后两维,K 取交换次序的前两维,V 取前两维。使用全 attention、无位置和无 dropout。第一个位置在第一头得到约 $(0.401112,0.796664)$,在第二头得到约 $(0.598888,0.802224)$。两头读的是同一组三个位置,却因投影不同而有不同权重和输出;下方可执行代码明确列出全部投影矩阵。
| 第一位置的读取 | 我 | 给 | 书 |
|---|---|---|---|
| head 1 | 0.401112 | 0.197776 | 0.401112 |
| head 2 | 0.197776 | 0.401112 | 0.401112 |
拼接为 $(a,b,c,d)$ 后,选择一个非平凡的输出投影,把它变成 $(a+c,b+d,a-c,b-d)$:
$$W^O=\begin{bmatrix}1&0&1&0\\0&1&0&1\\1&0&-1&0\\0&1&0&-1\end{bmatrix}.$$
第一个位置的 MHA 输出约为 $(1.000000,1.598888,-0.197776,-0.005560)$。这个构造说明多个头的内容怎样被合并;没有训练证据时,不能把第一头命名为“语法头”、第二头命名为“指代头”并当作真实模型规律。
4.9 原输入、残差与单行 LayerNorm
继续本章前面的两头全可见算例:多头输出已经回到输入宽度,现在将它与原 X 相加,再看每一行怎样归一化。
LayerNorm 对单个位置的 $d$ 个特征计算均值和方差:
$$\mu=\frac1d\sum_{r=1}^d x_r,\qquad \sigma^2=\frac1d\sum_{r=1}^d(x_r-\mu)^2,$$ $$\operatorname{LN}(x)=\gamma\odot\frac{x-\mu}{\sqrt{\sigma^2+\varepsilon}}+\beta.$$
$\gamma,\beta\in\mathbb R^d$ 是可学习缩放与偏移,$\varepsilon>0$ 防止除零并影响数值。这里不跨 token,不跨 batch,也不依赖 batch 中恰好还有哪些句子。归一化后的量经过仿射变换,不必仍为零均值、单位方差;即使省略仿射,epsilon 也使有限值下的方差略有差别。原始定义见 Ba、Kiros 与 Hinton,Layer Normalization。
原始 Transformer encoder 使用 post-norm。省略 dropout 的记号时,一层写成
$$U=\operatorname{LN}_1(X+\operatorname{MHA}(X)),\qquad Z=\operatorname{LN}_2(U+\operatorname{FFN}(U)).$$
训练中原论文还在子层输出上施加 dropout,再走残差和 norm。残差保留旧表示并加上子层计算,使模型不必每层从头重建全部信息。对 $x+F(x)$ 的导数是 $I+J_F$,有直接通路,却不意味着整个 block 的梯度恒为 1;post-norm 后面还有归一化 Jacobian。
4.10 接同一个 u:FFN 与第二次 Add & Norm
接着把第一次 Add & Norm 得到的 U 送进 FFN,再合并残差并归一化,走完同一个 post-norm block。 这里 $U$ 是所有位置组成的矩阵,$U_i$ 是第 $i$ 个 token 的整行向量,$U_{i,r}$ 才是该行第 $r$ 个特征;下文第一位置的四个数是 $U_1$ 的四个分量。
Attention 负责跨位置混合,FFN 对每个位置的通道做共享的非线性变换:
$$\operatorname{FFN}(x)=\operatorname{ReLU}(xW_1+b_1)W_2+b_2.$$
$W_1:d\times d_{\mathrm{ff}}$,$W_2:d_{\mathrm{ff}}\times d$。每行独立使用相同参数,因此 FFN 本身不直接从其他 token 读取信息;但它的输入已经可能包含 attention 汇总的内容。两个线性层之间的非线性使整体不退化成一次线性投影。
沿前面的两头例子走完一个位置。第一次残差后得到 $(2.000000,1.598888,0.802224,-0.005560)$。取 $\gamma=1,\beta=0,\varepsilon=1e-05$,第一次 LN 约为 $(1.170705,0.649589,-0.385419,-1.434875)$。FFN 中间宽度取 6,下方代码列出 $W_1\in\mathbb R^{4\times6}$ 与 $W_2\in\mathbb R^{6\times4}$,偏置为零。ReLU 之后的中间表示约为 $(1.170705,0.649589,0.000000,0.000000,0.521116,0.000000)$,投回后为 $(0.585353,0.324795,0.130279,0.000000)$。再加残差并做第二次 LN,最终约为 $(1.233154,0.588798,-0.424732,-1.397220)$。
这些数值来自明确的小算子,不代表模型已经识别某种语义。可以用下面代码复算全部位置,并逐行观察:
import numpy as np
# 参数和检查点由课堂同一 BLOCK 记录生成。
X = np.array([[1, 0, 1, 0], [0, 1, 0, 2], [1, 1, 0, 1]], dtype=np.float64)
WQ1 = np.array([[1, 0], [0, 1], [0, 0], [0, 0]], dtype=np.float64)
WK1 = np.array([[1, 0], [0, 1], [0, 0], [0, 0]], dtype=np.float64)
WV1 = np.array([[0, 0], [0, 0], [1, 0], [0, 1]], dtype=np.float64)
WQ2 = np.array([[0, 0], [0, 0], [1, 0], [0, 1]], dtype=np.float64)
WK2 = np.array([[0, 1], [1, 0], [0, 0], [0, 0]], dtype=np.float64)
WV2 = np.array([[1, 0], [0, 1], [0, 0], [0, 0]], dtype=np.float64)
WO = np.array([[1, 0, 1, 0], [0, 1, 0, 1], [1, 0, -1, 0], [0, 1, 0, -1]], dtype=np.float64)
W1 = np.array([[1, 0, 0, 0, 1, -1], [0, 1, 0, 0, -1, 1], [0, 0, 1, 0, 0, 0], [0, 0, 0, 1, 0, 0]], dtype=np.float64)
W2 = np.array([[0.5, 0, 0, 0], [0, 0.5, 0, 0], [0, 0, 0.5, 0], [0, 0, 0, 0.5], [0, 0, 0.25, 0], [0, 0, 0, 0.25]], dtype=np.float64)
epsilon = 1e-05
def head(Q, K, V):
    S = Q @ K.T / np.sqrt(Q.shape[-1])
    A = np.exp(S - S.max(axis=-1, keepdims=True))
    A /= A.sum(axis=-1, keepdims=True)
    return A, A @ V
def ln(H):
    mean = H.mean(axis=-1, keepdims=True)
    var = ((H - mean)**2).mean(axis=-1, keepdims=True)
    return (H - mean) / np.sqrt(var + epsilon)
A1, H1 = head(X @ WQ1, X @ WK1, X @ WV1)
A2, H2 = head(X @ WQ2, X @ WK2, X @ WV2)
attention = np.concatenate([H1, H2], axis=-1) @ WO
U = ln(X + attention)
ffn = np.maximum(U @ W1, 0) @ W2
Z = ln(U + ffn)
print(A1, A2, attention, U, ffn, Z, sep="\n")
4.11 把完整单元接回翻译模型
原始 base 模型使用 6 层 encoder、6 层 decoder,$d=512$,8 个 head,$d_k=d_v=64$,FFN 中间宽度 2048。以下维度账忽略 batch,并用源长度 $n$、目标输入长度 $m$:
| 位置 | 输入与 Q/K/V 来源 | 主要形状与输出 |
|---|---|---|
| 源 embedding+位置 | 源 ID 查表并加位置 | $X:n\times512$ |
| Encoder self-attention | Q/K/V 均来自本层源表示 | 每头权重 $n\times n$;输出 $n\times512$ |
| Encoder FFN | 每个源位置独立变换 | $n\times512\to n\times2048\to n\times512$ |
| Decoder masked self-attention | Q/K/V 来自移位后的目标表示 | 每头权重 $m\times m$,未来 mask |
| Decoder cross-attention | Q 来自当前目标;K/V 来自最终 encoder 输出 | 每头权重 $m\times n$;输出 $m\times512$ |
| Decoder FFN | 每个目标位置独立变换 | $m\times512\to m\times2048\to m\times512$ |
| 词表投影 | 最终 decoder 表示 | $m\times512$ 乘 $512\times V$,得 $m\times V$ logits |
把三个信息范围放在一起看,完整翻译器才闭合。源端已收到整句中文,各位置可以互看;目标端只有合法英文前缀,self-attention遵守因果范围;目标端同时通过cross-attention读取全部已知源句。预测book时,可以读取源侧“书”,却不能把目标侧尚未生成的book提前放进输入。这也说明“能看完整源句”和“不能看未来目标”并不矛盾。
Decoder 的每层有三个子层:masked self-attention、cross-attention、FFN,每个都带自己的残差/归一化。Encoder 只有 self-attention 与 FFN 两类子层。Cross-attention 的 query 来自当前 decoder 子层,key/value 是 encoder 表示的相应投影;不能把一个通用的只有 self-attention 的 block 冒充完整翻译模型。
4.12 已知训练位置与未知生成 token
预测 book 时,目标输入到 a 为止,masked self-attention 只允许使用合法目标前缀;cross-attention 可以读取完整源句,包括“书”。完整信息流是源 token→embedding/位置→encoder 各层→源表示;目标前缀→embedding/位置→decoder 各层→当前位置 logits→词表分布。目标 token 在训练时已知,所以同层所有目标位置可以在 mask 约束下并行计算;生成时后一个 token 尚未选出,仍需要顺序推进。训练并行不等于一次前向能产生所有未知目标。
4.13 不同长度的 batch 同时需要两种 mask
取两条手工分词源:A=我 昨天 给了 她 一本 书,B=她 笑了 PAD PAD PAD PAD。encoder与cross-attention中,B的位置2至5(从0计)都不可作为有效key。目标训练输入A=BOS I gave her a book,B=BOS she smiled EOS PAD PAD;目标标签B=she smiled EOS PAD PAD PAD,所以只有前三个loss有效。
对目标6×6 scores,causal允许矩阵为:
| query位置\key位置 | 0 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|---|
| 0 | 读 | 禁 | 禁 | 禁 | 禁 | 禁 |
| 1 | 读 | 读 | 禁 | 禁 | 禁 | 禁 |
| 2 | 读 | 读 | 读 | 禁 | 禁 | 禁 |
| 3 | 读 | 读 | 读 | 读 | 禁 | 禁 |
| 4 | 读 | 读 | 读 | 读 | 读 | 禁 |
| 5 | 读 | 读 | 读 | 读 | 读 | 读 |
还要叠加每条样本自己的key padding mask。短样本后面的padding query若被算出来,不代表其输出有监督意义;loss会排除。对cross-attention则没有目标式三角mask:每个合法目标query可读取整句已知源,仍要排除源PAD。用同一个“mask”名把这些规则混成一张三角表,会让翻译器错误丢掉右侧源信息。
4.14 非线性不是只由FFN提供
self-attention的softmax以及随输入改变的匹配权重已经使它是非线性计算;不能说“self-attention全是线性的,因此需要FFN才有非线性”。FFN的职责是逐位置做非线性通道加工:同一组权重用于各位置,每行内部混合特征,本身不再跨位置读取。多头提供多组可学习的子空间与读取,不能预先指定每头一种固定词义职业;LayerNorm沿当前token的特征轴统计。
4.15 质量、任务与预算一起读
结构让并行与短路径成为可能,实验才说明这些机制在当时任务与预算中值不值得投入。下面保留初稿时点,先看英德,再用英法检查结论边界。
2017 年 6 月:用当时可见证据排序
到这里,短路径、位置、mask、内容加工和训练方式都已形成机制理由;仍需问这些理由是否换来任务收益。先在英德看base的质量与估计成本,再转到英法检查原判断是否仍成立。若只读第一列,就容易把特定任务上的机会误写成所有翻译任务的统一结论。
GNMT 已有深层 LSTM、attention、残差与 wordpiece;ConvS2S 用卷积与 attention 组织序列,已经重视并行计算。这里采用 Transformer 2017-06-12 v1 的 Table 2,而不是将后续结果回填到初稿时点。
| 单模型 | 英德 BLEU | 估计训练 FLOPs(见口径) | 英法 BLEU |
|---|---|---|---|
| GNMT + RL | 24.6 | 2.3×10¹⁹ | 39.92 |
| ConvS2S | 25.16 | 9.6×10¹⁸ | 40.46 |
| Transformer base | 27.3 | 3.3×10¹⁸ | 38.1 |
| Transformer big | 28.4 | 2.3×10¹⁹ | 41.0 |
口径:上表GNMT与ConvS2S列的是原Table 2的英德成本;原表另列它们的英法成本。Transformer两行的成本单元格在原表跨英德/英法两列合并,不能将这里的单列误读为四个模型都在同一英德硬件协议下实测,也不能自行拆成两套精确任务成本。
base 在英德质量与成本两列都值得关注;换到英法,base 的排序变化。big 的 41.0 超过此前单模型,但低于当时 GNMT 与 ConvS2S 八模型集成的 41.16、41.29。后期稿中的 41.8 不属于本课这个情景。
训练 FLOPs 是论文按时间、GPU 数与估计持续 FP32 算力计算的文献比较,不是统一硬件复测。base 为 8 张 P100 训练 12 小时,big 为 3.5 天;这提供复现规模线索,不承诺任意硬件时间。结构表的 O(n²d) 是 attention 交互项;完整块还有投影和 FFN。相对于循环 O(nd²) 的优势受 n、d 影响。普通局部卷积依靠层叠扩大范围;O(log_k n) 的路径说法需膨胀卷积等条件。
这些结果使全attention成为有机制依据、也有任务证据的新路线。若当前目标接近英德,base的质量与成本组合值得验证;若目标是英法最高质量,则要同时考虑big与已有强集成的预算。统一数据和评测后,仍需测量质量、训练吞吐、峰值内存与错误类型。卷积若在相关任务、可比预算下同样准确且端到端更省,继续采用卷积也是合理选择;论文的一个排名不能替所有部署条件作决定。
可改判结果包括:统一条件后质量优势消失;可用硬件上的吞吐收益不足;长序列内存代价无法接受;结果不稳定。相反,若质量—成本曲线与关键错误类型都改善,再扩大投入。研究选择有明确倾向,也保留其适用条件。
4.16 2020:编码器与解码器可以分别选择
Google在2020年的系统改进介绍中采用Transformer encoder与RNN decoder的组合。源端需要把已经收到的句子编码成有用表示,目标端需要逐步生成;两侧的计算条件不同,便可以分别权衡编码质量与解码延迟。结构图中保留“源表示→逐步读取→词表→反馈”的接口,只替换各侧承担职责的部件。这里没有给未报告的延迟编造数值,也不把该系统经验推广成所有RNN decoder都更快。Google 2020原发布。
2021年的实时语音翻译进一步改变任务:输入还在到达,早显示可以减少等待,却可能需要回改已经显示的译文。因此质量、延迟与修订稳定性要共同评价。离线整句BLEU并未失效,但它独自不足以决定实时产品的显示策略。2021实时翻译发布。
2017的机制和实验让新计算图值得投入,2020的组合提醒我们把判断放回实际职责。结构图仍没有解释参数从哪里获得知识。下一章从同一段文字的训练目标、数据、规模与使用方式继续。
第五章 训练让能力改变,任务让系统分化
前面的翻译训练计算 $p(y_t\mid y_{<t},x_{中文})$。现在先移走中文源句,改为普通文本 I gave him a book yesterday . 的next-token学习:每个位置从已有英文前缀预测后继词,目标变成 $p(y_t\mid y_{<t})$。这改变了学习任务与可见条件;一条英语句子不再是“把已经知道的中文译对”的训练样本。
普通文本可由自身构造监督。GPT式因果预测、BERT式选中位置重建、T5式跨度去噪,是三种典型目标与输入组织;架构和目标不是永远一一绑定的定律。三个目标都需要实际训练。数据覆盖与质量、模型容量、更新次数和计算预算共同影响能力,仅把输入换成普通文本不会自动产生通用能力。
普通文本预训练之后,decoder-only也能被训练或提示用于翻译,但结构要真实改变:移除独立源encoder输出H及其cross-attention;把“请翻译成英文”、中文原句和英文前缀放进同一个因果上下文。预测him的英文位置通过self-attention读取前面的指令与中文,而不是暗中保留旧cross-attention。目标侧仍不能读取未来him标签。
训练用标签求loss,经反向传播和优化器更新共享参数θ;普通一次提示把文字或示例加入当前输入,通常只改变本次条件,不更新θ。指令微调继续训练参数,in-context示例则提供本次条件,两者须分别说明。能接入中文条件只说明计算通路存在;翻译表现仍取决于学习到什么以及具体评价。
下面三种目标的完整细则沿用原先独立文本 I gave her a red book yesterday .,保留其随机替换与跨度的原身份;它不是当前九单位翻译或新视觉蓝书的样本。
5.1 原始 BERT:选中位置才是重建目标
当前主例以him句解释三种典型目标;下面her/red例独立保留原BERT采样细节,不混作同一输入。
假设本次选中her和red两个位置。输入可以是 I gave [MASK] a blue book yesterday .,目标仍是这两个位置的her/red;其他未选位置不计MLM loss。encoder能读左右文,所以第一处可使用后面的book和yesterday。
原始BERT先选约15%的token作为目标,其中80%替换成MASK、10%随机词、10%保持原词。这个小句里选两处仅为了展示规则,不宣称单句恰好实现15%。保持原词的选中位置仍有loss,这是原配方的一部分;不能把它与因果预测中误把本步标签直接作为本步输入混为同一个错误。它让训练时不总是依赖特殊MASK位置,但也意味着不能把MLM loss直接当左到右整句概率。
原始BERT还训练Next Sentence Prediction,构造句段A/B并预测是否真正连续;并非所有后继encoder模型都保留这个目标。用BERT做句子分类还要选择汇总表示和任务头、进行相应训练,不能把“看到了完整句子”当成“分类已经会了”。
5.2 GPT 2018:完整句子拆成合法前缀预测
| 输入位置 | BOS | I | gave | her | a | red | book | yesterday | . |
|---|---|---|---|---|---|---|---|---|---|
| 目标 | I | gave | her | a | red | book | yesterday | . | EOS |
BOS/EOS在这里用于教学标清边界,具体实现的特殊token约定要另查;GPT2018原论文的核心是最大化因果语言模型目标,再监督微调下游任务。它不是今天聊天系统所有指令、偏好或多模态训练的总称。每一行当前输入只能参加其后一个token预测,mask保证并行训练也不接触未知未来。
“为啥生成时不知道下一词,训练时却能整句一次算?”因为训练样本提供所有已知的移位输入,但每个位置的依赖被限制;并行的是不同位置合法条件概率的计算,并没有把未来答案送给早期位置。回到路径A,还要观察真前缀与自馈前缀不同造成的实际轨迹。
5.3 T5:删去跨度,输出删掉的内容
手工删去gave与red book两段:
- encoder输入:
I <extra_id_0> her a <extra_id_1> yesterday . - decoder目标:
<extra_id_0> gave <extra_id_1> red book <extra_id_2>,再按实现加入结束符。
sentinel把缺口位置与要生成的片段对应起来。decoder不是重抄整个未损文本;它按顺序生成被删内容与分隔标记。其输入还要右移,起始token应服从具体实现,不能随意把课堂BOS强加给所有T5库。encoder可以看未删的左右文,decoder自己生成目标时仍遵守因果约束。
T5 JMLR2020的Figure2先展示独立抽取token再合并相邻跨度的基线;最终§3.7采用15%破坏率、平均跨度长度3。后续变体可换目标和配方,不能单凭“T5架构”推断每个checkpoint训练方式。
5.4 同一现象可以来自不同设计
如果模型正确补出her,可能利用了左右文,也可能只学到高频搭配;用 I gave him … 的对照会改变判断。如果一个新名字分成五片,抽样单位究竟是片段、整词还是连续span,会改变训练难度,必须查具体目标。要比较三类系统,请先固定任务和允许信息,而不是把重建准确率、生成PPL与下游分类混成一个排行榜。
来源:BERT NAACL2019 §3.1/附录A.1、GPT2018 §3、T5 JMLR2020 Figure2/§3.3.4/§3.7。本节是输入—目标设计的手工例子,没有新预训练结果。
5.5 从任务监督到预训练,再到使用方式
平行翻译语料给出源句与目标译文,监督直接对应翻译任务。广泛文本则可以把每个位置的后继token作为标签:监督由数据自身构造,不意味着数据无噪声,也不意味着模型获得了当前世界的全部事实。语料覆盖、质量、去重、分布、数据量以及可用计算共同影响能学到什么。
以next-token目标追一次更新:输入 BOS I gave,当前标签为her。模型输出整个词表分布,取 −log p(her | BOS I gave) 作为该位置loss;logit梯度是 p_j−1[j=her],再沿词表头、各层和embedding传播,优化器据此更新共享参数。标签her参与求loss,不能先放进这个位置的合法前缀。不同位置可并行求这些合法loss;它们共享参数,所以更新也会影响其他句子。
预训练后,任务微调或指令样例训练继续用损失更新参数,改变模型如何响应输入。In-context示例则写进本次输入,改变当前条件计算;普通一次对话不自动等于参数训练。两者可能都改善任务表现,却需要分别说明权重是否改变、使用了哪些示例、测试样本是否泄漏。
模型变大也不是把架构名改成GPT。参数量、训练数据量与计算量是不同但互相约束的研究变量;固定预算下增加一种资源可能挤压另一种。规模扩展的函数形式与训练配方可在后续课程继续;本讲先建立目标、信息与更新的具体关系。第七讲接搜索、推理与验证,第八讲接检索、记忆与上下文工程。
5.6 人物与术语必须保留时,先定义一个小任务
当前主线的受限schema为PER/ORG/LOC:原句我/他不是具名PER,昨天不在schema,只有明确赋名张明/李华后的新句才返回两个人名。以下人物/书名以及device_id任务是额外的schema设计实例,不能代替或偷改这项三类约束。
另设旧S30抽取例的句子:“昨天,小李把《机器学习》交给小王。”我们先把 schema 固定为“人物/书名”,任务是返回原文中的 span:人物为“小李”“小王”,书名为“机器学习”。书名号帮助定位边界,约定返回书名内部的文字;“昨天”虽然也是有意义的信息,却不属于这次任务的字段。这些是教学样例的人工参考,未宣称任何模型已运行。
字典可命中已知名字和书名;规则可利用书名号及周围文字约束边界,但要维护歧义与例外,例如只有姓氏、书名号缺失或同名实体。学习式标注器从标注数据学习 span 边界与类型,适合有稳定 schema 和可得标注的任务。GLiNER 式模型把类型描述与文本共同编码,并为候选 span 打分;它是现代双向 Transformer,不是“传统算法回来了”。开放生成能接受更自由的指令和解释,但必须检查它是否改写原文、发明实体或输出不合 schema 的字段。同一句话、同一组参考字段才构成这里的共同评价对象。
延伸时可以有意识地改变任务。换成“林岑将量子传感器样机QX-17交给李禾,地点为上海。”,并把 schema 改为 person / device_id / location,人工参考才相应变为 person:“林岑”“李禾”;device_id:“QX-17”;location:“上海”。这里的编号规则可以使用正则,但上一任务的“人物/书名”不能直接当成这次的完整 schema。文本与字段范围都改变后,需要重新检查覆盖、边界和误检,不能把两个任务的分数直接合并成模型优劣。
| 部署问题 | 应保留的比较 |
|---|---|
| 任务与schema固定吗 | 固定字段span抽取与开放生成分开测 |
| 错误的实际代价是什么 | 漏检、误检、边界错误、类型错误分别看 |
| 服务资源有限吗 | 同一请求分布的P50/P95延迟、吞吐、峰值内存 |
| 后续谁来维护 | 词典更新、训练数据、模型版本回归和分布变化 |
| 可重复输出是否足够 | 确定性只说明复现行为,不证明语义正确 |
GLiNER及后续工作说明紧凑编码器仍有活跃研究与实际价值;这些证据不足以断言全行业“复兴”,更不支持小模型普遍可靠。GLiNER2原表的CrossNER平均F1为.590,GPT-4o为.599,GLiNER-M为.615;其分类平均准确率.72对.84,也不支持“全面胜过”。CPU本地与远程API延迟包含硬件和服务路径差异,不能当成同硬件模型算力的因果比较。来源:GLiNER NAACL2024,Figure1/§2/Table1、GLiNER2 EMNLP2025 Demos,Table2–4。
NER 提供了一个能检验表示用途的任务。“Jordan scored again.”中的 Jordan 可能是人名,“They travelled to Jordan.”中的 Jordan 可能是地名。一个窗口分类器把中心位置左右各两个向量拼接为 $z_t=[x_{t-2};\cdots;x_{t+2}]\in\mathbb R^{5d}$,再计算 $h_t=\tanh(Wz_t+b)$、$p_t=\operatorname{softmax}(Uh_t+c)$。交叉熵同时更新分类器和 embedding。窗口边界需要明确的补齐规则;若采用 BIO 标注,还要区分实体开始、实体内部和非实体。逐位置独立分类可能产生非法标签组合,这也是后续加入序列约束或更完整上下文的理由。
这个小网络已经能说明“学到词向量”不等于“只看一个词”。词表提供可共享的起点,任务网络决定怎样利用本次语境。窗口 NER 与共同学习 embedding 的经典实例见 Collobert 等,Natural Language Processing (Almost) from Scratch,§3。
5.7 延伸:已经认识block,才比较现代改动
下面内容不要求按目录堆叠所有部件。先选一个具体瓶颈,再读相应算子、比较预算和可能反证。
你已经能沿“attention→残差/归一化→FFN→残差/归一化”追踪一行表示。现在有人说模型用了RMSNorm、SwiGLU、GQA和MoE。这些词不是给同一个东西换名:有的改变尺度,有的改变每个token的计算,有的改变参数如何被使用。先把它们放回原位置,才能问改动值不值得。GQA(分组查询注意力)让一组query头共享一个K/V头,以减少KV存储;完整定义见第七章§7.10。
5.8 归一化:放在哪里,处理哪一个轴
结构接通以后,训练还得稳定地把误差信号传回参数。联系L2关于学习率和梯度尺度的经验,一个自然问题是:同样的残差分支,归一化放在分支前还是相加后,会怎样影响较大学习率下的初始训练?这让一个部件选择对应到明确的损失曲线、梯度和失败率,而不只剩“哪个名字更新”。
post-LN:y=LN(x+F(x));pre-LN:y=x+F(LN(x)),完整pre-LN堆叠末端加最终LN。Xiong et al.(ICML2020)§3的初始化分析与§4的实验提供机制和任务证据。
采用Figure4的IWSLT14德→英设置:6层encoder+6层decoder,d=512,4heads,FFN=1024;Adam β=(.9,.98),最大/初始lr=5e−4。post-LN有4000步warmup及逆平方根衰减,pre-LN无warmup且第8epoch降到.1倍。两者约34BLEU,pre-LN第9个checkpoint与post-LN第15个近似相当。
这项对照同时改变了归一化位置和学习率调度,因而支持上述配置可行,不能把收益单独归因于位置,也不能把checkpoint差直接当硬件速度提升。要区分两个因素,可以设计位置×warmup的2×2,固定数据、tokenizer、初始化种子组、更新数、batch、优化器、最大学习率与warmup结束后的调度函数。先看loss曲线、各层梯度范数及失败率,再看固定预算验证NLL/BLEU。与已调优post-LN比较。历史证据来自原论文;这里的2×2是待执行实验,不是新训练结果。
设F=0,前者仍得到LN(x),后者保留x,这已经是不同的前向系统。pre-LN的残差通路不必每次穿过归一化,提供一种改善深层优化的动机;具体学习率、warmup与最终质量仍要训练验证。LAB03 F的开关只验证计算图,不是稳定性实验。
LayerNorm 与 RMSNorm 的算子区别
LayerNorm在每个token的特征轴上减均值并按方差缩放,再逐特征乘g/加b。它不把一行变成概率。常见无bias RMSNorm用
$$\operatorname{RMSNorm}(x)=g\odot\frac{x}{\sqrt{d^{-1}\sum_i x_i^2+\epsilon}}.$$
对x=(1,3)、g=(1,1),忽略很小eps,LN得到(-1,1),RMSNorm得到(1/√5,3/√5)。给两项同时加10,LN不变,RMSNorm会变;RMSNorm省掉均值中心化,不是数值相同的“快速LN”。论文讨论其缩放性质与效率;本课没有训练出RMSNorm更好的质量结论。
5.9 QK normalization处理匹配,不处理词表概率
Henry2020的QKNorm在每个head特征轴上把q/k做L2归一,再用可学习g乘余弦相似度作为score,替代普通的点积/√d_k。让某key整体放大10倍,普通点积会放大,归一后的方向匹配不变(忽略eps);g还可以控制softmax分布尖锐程度。它关注匹配尺度和softmax饱和,不是把V也归一,不是对token轴先做softmax。
现代实现有用RMSNorm处理Q/K的不同版本,不能套原论文L2公式而声称逐值相同。要复现实验,应记录归一轴、是否有可学习尺度、eps以及与RoPE的先后顺序。本节采用的是明确的2020设计,用来说明改动位置。
5.10 FFN 与 SwiGLU:每行自己的非线性计算
普通FFN为 W_2 φ(W_1 x+b_1)+b_2(这里列向量约定);同一参数处理每个token,attention已把别处内容带入x。激活使它超出一层线性变换。其宽度常大于模型维度,既是表示能力来源,也是decode时不可忽略的计算。
用行向量写SwiGLU:
$$u=xW_u,\quad g=xW_g,\quad \operatorname{SwiGLU}(x)=(\operatorname{SiLU}(g)\odot u)W_d,\quad \operatorname{SiLU}(a)=a\sigma(a).$$
两条投影分支逐元素相乘,一条调节另一条的通过程度。SiLU不是只取sigmoid;负输入也可以产生负门值。这不是LSTM跨时间保存的forget gate,它作用在当前token的FFN中间特征。若普通FFN中间宽4d,两大矩阵约8d²参数;SwiGLU三矩阵要用约8d/3中间宽才近似同参数预算(忽略bias和硬件整除)。直接把宽度都设4d再比性能,额外参数与FLOPs也变了。
5.11 MoE:总模型很大,一次只调用一部分
想象三个FFN专家E1/E2/E3,router对一个token输出(.1,.7,.2)。在Switch具体top-1约定里,只计算E2,输出乘.7;并不是所有top-1实现都自动重新归一为权重1。其他模型可用top-2等路由,权重归一、容量和丢弃规则都要按实现说明。
如果一批token都涌向E2,另两个专家空闲,E2却拥挤。负载平衡loss、容量限制、跨设备通信因此进入问题。假如每专家有P参数、共有E个,每token调用k个,总专家参数EP,激活专家参数约kP,另加共享层和router;这些数与延迟、设备内存也不是同一量。只宣称“总参数翻倍但FLOPs不变”会漏掉路由、通信和实际batch效率。
对实验设计而言,先固定数据、激活计算与训练预算,再看质量和吞吐;还应记录丢token/容量策略。当前读本只解释机制与比较条件,没有训练MoE成绩。
5.12 位置与 RoPE:相对关系如何进入匹配
加性位置在输入embedding处加入位置向量,原Transformer用正弦/余弦;学习式绝对位置也可用。RoPE把q和k的每对坐标旋转:列向量约定下q_i'=R(iθ)q_i、k_j'=R(jθ)k_j,于是
$$q_i'^T k_j'=q_i^T R((j-i)\theta)k_j.$$
共同平移i/j同一数量,在这个局部匹配式里保留相对旋转;不同频率的二维子空间共同承载位置关系。例:q=k=(1,0),θ=π/2,位置差0时点积1、差1时0、差2时−1,说明同一内容因相对距离得到不同分数。这是构造旋转,不是训练出的语言关系。
“式子含相对位置”并不保证从训练长度外推到任意长文档:未见距离的相位组合、频率、训练数据、模型利用方式都可能不同。模型也不能只靠位置知道哪条消息被撤回。去上下文路径时,要把几何可计算、cache有效与事实使用分别检查。
5.13 一次有约束的比较怎样开始
训练初期loss不稳定:可能归一位置影响梯度,也可能学习率过大或mask有错。先用已有数值链排除前向/遮挡错误,再做pre/post×warmup的2×2训练,会比同时换RMSNorm/SwiGLU/初始化更能区分解释。显存紧张则先列参数、激活、KV各占多少;MoE和GQA解决的并非同一瓶颈。这些是未执行的研究方案,不要求每个学生把所有现代部件都训练一遍。
来源:Xiong2020、RMSNorm2019 v1、QKNorm2020 §3、GLU Variants2020、Switch2022 §2、RoFormer v5 §3。原始提出年份与实际核读版本分别记录;不把后续修订内容当2017已知事实。
5.14 先画比较轴,再读新架构
如果应用是持续到达的长输入,并不只有保留所有历史位置这一条路;还可以改变历史的保存方式。相反,若任务需要临时回查许多细节,逐位置材料可能值得保留。沿同一任务与预算比较新结构,才不会把不同问题上的优势混成架构排名。
读新的序列模型,先问:历史保存在哪里,当前输入怎样改变更新,远处内容能否被直接寻址,训练计算怎样并行,生成状态随长度怎样增长。这些问题比记一串模型名更能帮助判断设计。
| 路线 | 历史主要怎样保存 | 新位置怎样利用历史 | 固定配置下生成状态随长度 |
|---|---|---|---|
| 标准 causal attention+KV cache | 每层逐位置 K/V | 当前 query 对所有合法旧 key 配对读取 | 通常线性增长 |
| 普通/门控 RNN | 当前 hidden/cell | 经共享更新函数压入新状态 | 不随已读长度增长 |
| 时间不变线性 SSM/S4 类 | 结构化状态 | 固定动力学更新;可等价为卷积核 | 不随已读长度增长 |
| 原始 RWKV | 按通道累计的加权量及局部状态 | 时间混合、衰减汇总与输出门 | 不随已读长度增长 |
| 原始 Mamba | 选择性 SSM 状态及局部卷积状态 | 输入影响写入、读取与离散步长 | 不随已读长度增长 |
“不随长度增长”以层数、宽度和状态维度固定为前提,不表示绝对内存小,也不保证能无损保存任意多信息。缓存 attention 保留更多逐位置材料,便于当前 query 重新选择,但支付存储和读取成本。压缩状态把选择更多放在写入与更新时,可能适合流式处理,也需要验证任务所需细节是否还在。混合架构可以结合两种接口,表格不是只能二选一的宣言。
5.15 SSM:状态更新与卷积可以是同一件事
先从一个最小联系开始:如果状态更新是线性且固定的,把多步递推展开,每个过去输入便带着与距离有关的系数贡献到输出。这些系数恰好组成卷积核。因此递推和并行组织并非永远对立,需要检查具体运算。
连续线性状态空间模型写作
$$\frac{dh(t)}{dt}=Ah(t)+Bu(t),\qquad y(t)=Ch(t)+Du(t).$$
把输入按步长 $\Delta$ 离散化,可得到 $h_t=\overline A h_{t-1}+\overline B u_t$,其中零阶保持离散化为 $\overline A=e^{\Delta A}$、$\overline B=\int_0^\Delta e^{sA}B\,ds$。若系数固定且 $h_0=0$,展开递推得到
$$y_t=\sum_{k=0}^{t-1}C\overline A^k\overline B\,u_{t-k}+Du_t.$$
同一线性系统既可逐步递推,也可视为一个长卷积核。训练拿到完整序列时,可以利用卷积组织并行;生成时则递推固定大小状态。S4 的重要工作是对状态矩阵作结构化参数化,兼顾长程动力学与高效核计算,不是简单把普通 RNN 改名。阅读 Gu、Goel 与 Ré,S4,§2–3时,先找到递推、卷积与矩阵结构之间的对应,再看任务结果。
这个等价有条件:固定系数、线性、时间不变。若希望“看到钥匙事实就写入,看到无关电话就忽略”,固定卷积核本身不能随内容决定某一步的写入力度。这为输入依赖的更新机制提供了问题位置,但不等于由此证明所有时间不变模型在所有任务上都无用。
5.16 RWKV 与 Mamba 怎样重新安排选择
固定动力学给出一种紧凑保存历史的方法,但钥匙任务提醒我们,内容可能需要影响保留或写入。RWKV与Mamba提供了两种具体组织方式;下面比较其算子,不把它们统称为同一种attention替代品。
原始 RWKV 把一部分时间混合写成按通道的加权汇总。用论文中的概念表示,历史项按时间衰减,当前项有单独偏置:
$$\operatorname{wkv}_t= \frac{\sum_{i<t}e^{-(t-1-i)w+k_i}\odot v_i+e^{u+k_t}\odot v_t} {\sum_{i<t}e^{-(t-1-i)w+k_i}+e^{u+k_t}}.$$
这里指数、乘法和除法按通道进行,$w,u$ 是学习到的量。输出还由 receptance 的 sigmoid 门调节并投影。历史分子、分母可以递推累计,所以不必保存每个位置的 K/V;稳定实现还需维护缩放量,防止指数溢出。它不计算标准 attention 的完整 query–key 两两分数矩阵。原论文将大投影矩阵计算并行化,并为时间递推使用专门 kernel;不要把它概括成所有时间运算都与全 attention 完全相同地并行。见 Peng 等,RWKV,§3、附录 D。这里介绍的是该论文版本,不把后续 RWKV 系列的全部变化混入一式。
Mamba 在 SSM 上加入输入依赖的选择。原始模型让 $B_t,C_t,\Delta_t$ 由当前输入产生,离散化后形成依赖该位置的 $\overline A_t,\overline B_t$:
$$h_t=\overline A_t h_{t-1}+\overline B_t x_t,\qquad y_t=C_t h_t.$$
这是概念级核心式,完整 block 还含投影、局部卷积和门控等运算。并非所有矩阵都被任意设成输入函数;原论文具体选择了哪些量变化,必须按算法读。输入可以影响保留、写入与读取,因此更能选择哪些内容穿过状态。代价是失去单一固定卷积核的等价,需要新的高效执行方法。Gu 与 Dao,Mamba,§3.1–3.3。
仿射递推也有可并行扫描的结构。把一步写成变换 $h\mapsto A_th+b_t$,两步合成为 $(A_2A_1,A_2b_1+b_2)$;合成满足结合律,因此能组织 parallel scan,而不必把全部工作做成逐 token 的 Python 循环。实际收益还需要利用矩阵结构、融合算子与内存层次。Mamba 的“线性时间”讨论限定模型和实现里的序列长度轴;宽度、状态维度、精度与硬件常数仍然存在。
5.17 同一条传感流,可能需要两种历史
仪器每秒上报一条事件,大多数是“正常”,少数是“报警开启/解除”。第一项任务只问当前报警是否有效,有限状态就可能足够。第二项任务突然问“17分钟前、设备B、维护员刚换班后那次异常的原始读数是多少”,这需要按新query回查具体旧材料。两个任务都很长,但要求保存的信息不同。
RNN把历史压入递推状态,生成时状态大小通常不随长度增长;attention保存逐位置表示或K/V,允许当前query重新寻址,代价随保留长度增加。不是所有应用都值得付出完整历史寻址成本,也不是固定状态一小就自动丢掉任务需要的信息。比较之前先说明输入流、查询类型、延迟、内存和训练预算。
5.18 取舍要能被一个观察推翻
| 问题 | 小递推状态可能有利 | 保留逐位置材料可能有利 |
|---|---|---|
| 当前有效报警 | 关心有限充分状态,低延迟常驻 | 若规则复杂、需要回查证据,保留日志也有价值 |
| 临时追问某次原始读数 | 若训练学到所需统计或接外部日志,可回答部分问题 | 当前query直接寻址旧材料;代价是缓存增长与读取计算 |
| 长流训练 | 固定核卷积或选择性scan可并行 | 已知序列attention也可并行,但密集交互成本更大 |
| 生成资源 | 递推状态通常定长 | KV随保留长度增长;检索/窗口策略可改变接口 |
可以成对构造只在关键事件不同的流,保持后缀相同,再改变查询是在训练时常见的“当前状态”还是新加入的细节追问。若小状态方案稳定满足前者,保留它是合理结论;若attention对后者也失败,先查训练覆盖和实际输入,不能只凭可寻址接口宣布能力已经存在。这里的S4、RWKV与Mamba分析依据原论文机制与结果;上面的传感流比较是待做研究设计。
来源:Transformer v1、v7对照;S4 ICLR2022 §2、RWKV v2 §3/附录D、Mamba v2 §3.2/附录C;R7读本第四、五章。它们是具体版本的比较,不是按模型家族名称下统一结论。
5.19 语言训练仍不能替代当前实例证据
规模、目标与适配可以改变统计能力,却不会让未提供的书本颜色自动成为事实。即使准确理解“我昨天给了他一本书”,仍不知道书是什么颜色。下一章要补的首先是同一事件的视觉信息,然后才讨论它怎样进入语言计算。
第六章 图像怎样成为语言计算的新证据
“我昨天给了他一本书。”没有说明封面颜色。即使准确翻译整句,也不能据此断言blue;未知不是计算错误。现在明确给定一张同一事件的教学情境图:男性接收者收到一本蓝封面书。图像提供可见颜色和场景,中文仍提供昨天及说话者角色;单张图不能独自证明事件发生在昨天或谁是说话的我。
这时任务也明确改变为:结合这句话和图片,用英文描述这次给书,并补充封面颜色。 在这个新任务下可以选择参考描述 I gave him a blue book yesterday.。若任务仍只是忠实翻译原文,擅自添加blue就不是同一个评价目标。红封面控制图保持事件安排,主要改变封面颜色,水彩纹理有轻微变化,不能称为逐像素唯一差异;它用于提出可检验预期,没有新的模型准确率。
同一蓝图覆6×4网格,四个展示裁片确实裁自该图。24格是解释局部像素到序列的教学选择,不是LLaVA实际视觉token配置;一本书可以跨多格,一格也可能混合多个对象。裁片先经视觉encoder形成可含全图上下文的表示,再投影到语言模型宽度。画一列格子只是接口,不能冒充已经识别出对象。
这里采用LLaVA v2的视觉前缀路线:视觉表示、任务问题、中文和合法英语前缀进入语言decoder。当前英语前缀为 I gave him a,a位置的query可读取此前视觉与文本位置以及自己,blue尚在输出候选端。经完整层与词表头选择blue后,下一步把blue接回,blue行再预测book;继续生成yesterday、句号与EOS。这样书的颜色确实经过了“条件→当前表示→词表预测→反馈”的链,而不是让还未生成的blue先参与自己的预测。
语言部分是合并序列上的causal self-attention,视觉encoder则可处理整张已知图片;两种可见边界不同。采用视觉前缀也不等于先把图像人工写成标签,更不等于一个CLIP相似度分数。
换蓝封面为红封面,预期颜色词相应变化;只改不相关背景,预期给书关系与颜色保持;以不透明灰色封套遮住封面,则应承认证据不足;封套不是书本的灰色封面。这三项是待执行的事实使用控制,不是已得到的能力结果。下面另行保留LAB14受训几何问答和LAB03随机cross-attention的完整样本、数值和代码,它们分别回答不同问题。
第三讲P64留下的视觉token问题在这里接到完整生成;第四讲的文本约束视觉生成则方向相反。以下先完整说明所选训练接口,再区分两项已有实验。
6.1 视觉前缀怎样参加同一语言计算
当前a→blue→book的过程已明确任务和合法输入。视觉encoder的每个输出可以含全图信息,投影将其宽度对齐到语言模型;接入前缀以后,图像位置参加后续语言层的K/V计算。原LLaVA v2允许首轮图像在问题前或后,本章固定在前,不能据此断言所有VLM都必须采用这个格式。
6.2 三种patch数量,分别属于三种设计
224×224图像按16×16切分时有14×14=196块,每块原始RGB像素有16×16×3=768个值。若采用原ViT式CLS聚合,可能在196个patch之外加一个CLS,成为197行;无CLS均值池化是另一种设计。经过视觉encoder之后,每行可含全图上下文,token不等于物体。
原LLaVA采用CLIP ViT-L/14,实际视觉token数取决于其分辨率与配置,不能把上述196贴给它。给书情境图用6×4教学网格标出24格,实际展示中央四个由同图导出的真实裁片;它只解释从同一图的局部像素到表示的过程,不冒充CLIP ViT-L/14的配置。本课LAB03则进一步简化:每块只取RGB均值与x/y共5维,再做固定随机投影。这不是训练ViT的patch embedding。原图、真实切片与模型处理后的表示需要分开读。
6.3 训练职责:什么更新,哪些位置计损失
“冻结”表示优化器不更新该模块参数,不表示跳过它的前向计算。阶段1视觉encoder和语言模型仍实际处理输入,只有投影更新;阶段2视觉encoder继续前向且冻结,投影与语言模型共同更新。
| 原LLaVA v2阶段 | 视觉encoder | 投影 | 语言模型 | 监督位置 |
|---|---|---|---|---|
| 阶段1,对齐 | 冻结 | 更新 | 冻结 | assistant答案与终止token |
| 阶段2,指令微调 | 仍冻结 | 更新 | 更新 | assistant答案与终止token |
图像、系统/用户问题提供条件,不作为同样的目标词逐项计答案loss。CLIP图文对比训练学习匹配关系;这里学习的是 p(answer | image, question) 的条件生成。冻结已训练视觉encoder可复用已有视觉表示,不能把冻结随机投影也称作拥有视觉知识。这是原LLaVA的流程,不是所有VLM都必须遵循的训练法。来源:LLaVA v2物理p4 Figure1/§4.1、p5 Table2,第三讲P65。
6.4 已训练能力:第三讲的受控像素问答
第三讲P54 state1/LAB14保存记录使用720张训练图、180张留出图,每图数量/左色/右形三类问题,共2160/540图问对。输入实际RGB像素与问题模板ID,不是直接输入属性真值。下面引用2026-09-22本地CPU保存结果,
| 条件 | 数量 | 左色 | 右形 | 总体 |
|---|---|---|---|---|
| 图+问,已训练视觉模型 | 100% | 100% | 100% | 100% |
| 问题only,另行训练的模型 | 50% | 33.33% | 50% | 44.44% |
| 零图,既有视觉模型输入控制 | 50% | 33.33% | 50% | 44.44% |
| 循环错配图,既有视觉模型输入控制 | 83.33% | 50% | 0% | 44.44% |
问题only与零图不是同一个训练干预;循环错配也不是独立随机配对。错配部分保留数量关系,却系统改变形状,分项结果不能用相同总体覆盖。44.44%来自此任务分布,不是七类均匀随机猜测的1/7。这些结果支持有限受控任务中训练后的像素利用,不是自然图像通用问答,也不是LLaVA成绩。
6.5 另一条通路:本课未训练的cross-attention实验
下面切换到LAB03已存在的湖边图与bank图。给书图用于提出“当前实例缺少什么事实”;这两张图用于检验固定数值通路。不能把一幅图的实验结果贴到另一幅图,也不能把该随机cross-attention实验拼成上面的LLaVA视觉前缀实现。
图A里,一位戴帽子的人坐在湖边长椅上,旁边有一只狗;图B由两幅场景组成,一侧是在银行柜台交接纸币,另一侧是在河岸边读书。它们是课程已有的情境插画。下面把两张实际图片文件交给同一个数值接口,语言前缀都固定为 a scene。
读图任务:先由人指出一条可见事实,再查模型输出是否真在检验它。“图片不同”只是干预条件,“人旁边是否有狗”才是一个可以定义正确性的视觉问题。当前六词词表甚至没有dog,不能把它的下一词分布叫成对这条事实的回答。
6.6 完整设计与本实验替代物要并排看
在另设的独立cross-attention接口中,pixels切成patch,经视觉encoder产生Z;目标合法前缀经因果语言网络形成query;视觉K/V由Z投影,读取结果加入语言支路,再由词表头预测下一词。这是该实验所参照的cross-attention接口母图,区别于上文LLaVA主路线。当前实验刻意把多数环节换成可查看的轻量量值,没有训练好的图像描述模型。
| 环节 | 当前实际实现 | 能说明什么 |
|---|---|---|
| pixels→patch | RGB缩放到224×224,16×16 patch,共14×14=196个 | 预处理与空间位置可核对;缩放可能改变形状 |
| patch→特征 | 每patch的RGB均值3维,加归一化x/y坐标2维 | 人工特征,共196×5;没有对象识别器 |
| 特征→Z | 固定随机5×8投影 | 196×8未训练表示,不是视觉Transformer encoder |
| 语言前缀→query | 两个token embedding取平均,再乘8×4矩阵 | 连前缀顺序也丢了;不是完整因果decoder |
| Z→K/V | 各乘8×4随机矩阵 | 196个4维key/value |
| 读取→语言贡献 | softmax(qKᵀ/√4)V,再乘4×8并加bias | 数值条件通路 |
| 残差→输出 | 语言向量加视觉贡献,再乘8×6词表头 | 六类随机分数,不是识别正确率 |
所有参数固定于种子20261016。词表为a/scene/river/person/bank/EOS;给向量列取这些名字,不会让随机参数自动学到这些概念。完整系统和当前替代物共享接口关系,所以可以测试依赖和消融;它们不共享能力结论。
6.7 换图必须重算哪一些量
固定的是参数、前缀与评分规则;变化的pixels必须重新生成patch、Z、K/V、权重与视觉贡献。只替换展示图片,却继续用旧K/V,会假造“模型不受图像影响”的结果。沿数组核对才能知道实验实际改了什么。
| 条件 | a | scene | river | person | bank | EOS |
|---|---|---|---|---|---|---|
| A on | 0.281995 | 0.156665 | 0.161435 | 0.145756 | 0.117070 | 0.137079 |
| B on | 0.279580 | 0.156957 | 0.161655 | 0.146479 | 0.117072 | 0.138256 |
| A off | 0.138194 | 0.208762 | 0.142520 | 0.203402 | 0.145650 | 0.161473 |
| B off | 0.138194 | 0.208762 | 0.142520 | 0.203402 | 0.145650 | 0.161473 |
实际max|ΔZ|=0.922170018;开分支max|Δlogits|=0.016440292;关分支max|Δlogits|=0.0。
| 张量 | 实际shape |
|---|---|
| features | [196, 5] |
| Z | [196, 8] |
| Q | [1, 4] |
| K | [196, 4] |
| V | [196, 4] |
| weights | [1, 196] |
| read | [1, 4] |
| branch | [8] |
| logits | [6] |
图中每格对应16×16像素的一个patch;热图沿196个位置归一,颜色只表示权重,不能把色块命名为识别标签。
两张图开分支后logits有变化,但两张图的argmax仍都是a;“输出变了”在这里准确指概率/分数变化,不是生成了一句不同且正确的描述。关掉视觉分支以后两张图的logits逐元素相同,支持本实现的这条图像通路已被干净关掉。
读这张表先分清三个对象。词表头给出未归一化分数 $\ell_j$(logits),softmax将它变成 $p_j=\exp(\ell_j)/\sum_k\exp(\ell_k)$,greedy只取概率最大的词。图A/B的a概率约0.281995/0.279580,都仍大于各自其他项,所以分布变了,选择却没变。另一个边界是:给所有logits同时加同一常数,softmax概率完全不变;因此不能从两张概率表唯一倒推出原始logits的最大差。本节的0.016440292来自直接比较两次计算保存的logits,不是由概率表猜出的能力阈值。
门必须放在投影包含bias之后:branch=enabled*(read@O+bias),再加到语言残差。只把read设零还会留下bias;把所有attention score设为−∞则会制造未定义softmax。两者都不是这里采用的关闭方式。
分支实现见§6.11“复核与实现”;先继续检查这张权重图能说明什么。
6.8 集中的热图为什么仍不够
本图有196个位置,完全均匀的权重是 $1/196\approx0.005102$。实际色标约0.0049–0.0054,数值接近这条均匀基线;自动拉伸色标可以制造鲜明色差,不能据此说读取已经高度集中。先读数值范围,再讨论具体位置及其value。
假如随机query偏好亮色patch,热图就可能集中在天空或纸币区域;并不需要识别“河岸”或“银行”。有颜色差异就可以改变Z,继而改变输出。高权重位置传输的是value,value可能已包含周边信息,也可能只是人工颜色坐标;后续输出头还会改变贡献方向。热图是一条中间计算证据,不是语义标签。
遮挡某块后分布改变,能说明这个输入改动影响了系统;遮挡也改变颜色统计和分布,不能独自证明被遮对象是因果识别依据。若把一整条视觉支路关掉后仍有图像差异,先查是否还有未关闭的视觉路径或参数没有固定。若开分支换图完全无差异,可能没重算K/V,也可能头将差异抵消。检查中间Z/K/V与分支向量能区分这两类解释。
6.9 同图不同任务,为什么接口不同
整图分类通常把Z池化成一个向量,或让专用CLS位置汇总后接类别头;它只需对整图给一次判断。逐词生成则可能先说人,再说动作,再说地点,每次前缀不同,读取需求可以不同。让某种汇总适合一个分类目标,不代表它能无损保留所有描述细节。
2015年的Show, Attend and Tell已经用CNN空间特征、随目标前缀变化的attention与LSTM生成描述。2017情景的新假设是替换语言骨干及其计算组织,不能把视觉读取本身宣称首次出现。原始ViT常用可学习CLS与位置embedding;本实验的RGB+xy没有复现那套训练。
如果冻结一个已训练视觉encoder,只训练适配层/读取接口,通常能降低需要更新的参数与反传开销,但原表示丢掉的信息未必能靠适配器恢复。联合训练允许任务梯度改变视觉表示,可能需要更多数据、显存和优化协调,也可能损伤原能力。“冻结”只有在明确冻结的是何种权重时才有意义,冻结随机encoder不等于拥有通用视觉知识。这些训练方案在本课中作为待做研究设计。
6.10 返回四臂检查,再设计真正的事实任务
把本主题URL和你观察到的概率变化交给Agent,可以用日常语言问“它看见了狗,还是只对颜色敏感?”正文足以让回答方指出词表、随机权重与平均前缀的限制。返回LAB03“路径B · 换图后分布变了,模型是否看懂了”,固定参数/前缀,对A/B各运行开和关分支:
B = paths.path_b(ROOT)
display(pd.DataFrame(B['probabilities'],index=B['conditions'],columns=B['vocab']))
print({k:B[k] for k in ['max_Z_change','max_on_logit_change','max_off_logit_change']})
assert B['max_off_logit_change']==0
下一项事实评测可用成对图片:相同场景、人物和光照,只有“钥匙在桌上/柜中”这一关系不同,同一问题要求不同答案;评价单题正确率与一对全对,并防止背景或文件名泄漏。遮挡相关对象和无关区域、换图和无图控制分别做。先需一个确实训练过的模型、未泄漏测试集和明确标签;目前两张插画的四臂计算没有提供这类能力成绩。
来源:原R7.1第六章、S31–S35扩展,当前视觉描述入口为T44–T49;LAB03 mechanisms.py;Xu等2015 §3、ViT v2。插画沿用已有ImageGen来源;概率是既有DN2 CPU机制复算;冻结/适配/联合训练与成对事实任务为未执行研究设计。
6.11 复核与实现
下面保留完整分支函数,可对照含bias的关闭位置。
def vision_read(image_path,p,prefix=(0,1),enabled=True):
    image=np.asarray(Image.open(image_path).convert('RGB').resize((224,224)),float)/255
    patches=image.reshape(14,16,14,16,3).transpose(0,2,1,3,4)
    rgb=patches.mean((2,3)).reshape(196,3)
    yy,xx=np.meshgrid(np.linspace(0,1,14),np.linspace(0,1,14),indexing='ij')
    features=np.column_stack([rgb,xx.ravel(),yy.ravel()]);z=features@p['encoder']
    language=p['embedding'][list(prefix)].mean(0);q=language[None]@p['Q'];k=z@p['K'];v=z@p['V']
    read,weights=old.attention(q,k,v)
    projected=read[0]@p['O']+p['bias']
    branch=float(enabled)*projected  # gate AFTER bias, BEFORE language residual
    logits=(language+branch)@p['head'];probabilities=old.softmax(logits)
    return dict(image=image,features=features,Z=z,Q=q,K=k,V=v,weights=weights,
                read=read,branch=branch,logits=logits,probabilities=probabilities)
6.12 同题换图与同图换题,怎样评价事实使用
对同一问题换相关图、错配图或无图,检查目标事实准确率及一对都对;对同一图改变问题,检查模型是否转向所问属性。句子改变只说明行为敏感,不能证明改变方向正确。答案应限于可见证据,图像不能保证镜头外物体、人物意图或过去事件。背景、文件名和模板泄漏也要控制。
6.13 其他接口为什么值得保留
2015年Show, Attend and Tell用CNN空间特征、动态读取和LSTM生成字幕;它说明视觉读取并非2017年之后才出现。Flamingo使用NFNet CNN视觉骨干、Perceiver Resampler与插入语言模型的独立cross-attention,不可拿ViT patch示例标为其原结构。BLIP-2使用Q-Former连接冻结视觉encoder与冻结语言模型,是另一种压缩/桥接选择。它们回答怎样传递视觉条件的不同问题,没有在本课被同时复现。原始来源:Show, Attend and Tell §3、Flamingo §2、BLIP-2 §3。
6.14 RNN视觉条件生成的历史接口
字幕模型可以用图像 encoder 给出条件表示,再用这样的序列网络输出 BOS 之后的词。例如把湖边人物与小狗的图像编码为 $v_{\mathrm{img}}=f_\theta(I)$,再由 $h_0=W_{\mathrm{img}}v_{\mathrm{img}}+b$ 初始化 decoder。这个历史RNN字幕示意采用初始化接口;将特征每步注入属于另一实现。它与上文LLaVA和独立cross-attention接口分开。Decoder 随后读 BOS,预测第一个字幕词,把已知训练词或自己生成的词逐步接回,直到 EOS。训练损失为 $-\sum_t\log p(y_t\mid y_{<t},I)$,监督来自图像与字幕配对,不是图片自己附带了目标句。
一张图可能有多条同样正确的描述:一句强调人物坐在长凳上,另一句强调旁边的小狗。仅凭词序不同不能判断哪条一定错误,生成内容是否被图像支持更重要。如果图像只通过一个固定向量进入,生成各词时仍只经由这个接口使用图像;视觉 attention 则允许逐词读取不同区域特征。它与本章LLaVA视觉前缀和LAB03随机cross-attention各有明确接口,不借用彼此的实验成绩。
6.15 从更多视觉材料进入资源问题
高分辨率、更多图像或更长文档可以带来更多证据,也会增加表示、读取与存储。先用下面的独立颜色问答回看一次视觉条件和合法答案前缀,再进入资源问题。
6.16 独立旧问答接口:The book is → blue
这个独立旧问答示例采用LLaVA原论文v2的视觉前缀接口:图像经过视觉encoder得到一列视觉表示,投影到语言隐藏维度,作为语言decoder的视觉前缀,再接问题与合法答案前缀。原论文首轮允许图像在问题前或后;这里选图像在前,不把它画成所有VLM唯一的格式。
视觉encoder中的位置可读取整张已知图像,因此一个位置的表示不等于一个孤立物体。语言decoder按序列因果规则处理这些表示。假设已知前缀是 [视觉位置…] [问题:书是什么颜色?] [答案前缀:The book is],此刻is位置要预测blue。从is这个最后合法前缀位置产生query,读取不晚于该位置的视觉、问题与已知答案位置的K/V,包括该位置自己;再经后续层与词表头预测颜色词。待预测的blue只作为这一步的训练标签,尚未进入这一步的合法输入。下一步若接入blue,它才成为预测终止token等后继内容的条件。
这一层的Q/K/V来自合并后的同一序列,因此是causal self-attention。视觉条件不必先转换成“红书”“人物”等标签,也不是一个CLIP相似分数。图像prefix可以含许多位置;每层都有自己的投影、读取与后续变换。视觉encoder全可见与语言decoder因果可见是两种不同边界,不可画成一张没有边界的全连接图。
读完这个独立问答,可以把注意力放回同一事件的逐词描述。下一章先保留数学计算和答案目标,追踪哪些旧计算能够复用、哪些大中间量不必写回,再分别评价速度、容量与事实正确性。
第七章 同一attention怎样改变执行
图像与文档增加输入后,既要问答案有没有证据,也要问系统能否装下、多久完成。先从两次相邻生成识别可复用的旧K/V,再用分块与在线softmax追踪同一读取怎样少搬运。
训练已有完整右移目标,多个query在mask约束下计算并反向传播;prefill已有完整前缀,多个query作前向并建立缓存;单步decode通常只增加一个query,读取已有历史。下文从生成过程出发,始终保留这三个阶段的区别。
7.1 训练、prefill 与 decode 的输入形状
延续视觉描述的同一个时刻:刚选中blue,历史已处理到a,下一次送入的新token是blue,接下来预测book。每一层均已保存截至a的旧K/V;blue在第一层产生新Q/K/V,追加本层K/V并读取历史及自己,再把该层输出送给第二层。第二层用自己的投影与缓存重复这一过程;不同层的K/V不能互相借用。
旧位置不能读取后来追加的blue。若旧前缀、位置规则、模型参数和确定性运行条件不变,旧位置的第一层输出不变,第二层输入也不变,逐层可以证明旧K/V仍合法。被省掉的是旧位置的重复投影和后续表示计算;新token的Q/K/V、FFN、输出头以及读取历史都仍要算。图像、问题或中文前缀改变时,相关历史表示也改变,旧缓存必须作废或按确切依赖重新计算。
原encoder–decoder另有cross-attention的源K/V缓存,它来自固定源H,不随目标每新增一个token而增长;这与decoder-only合并序列的self-attention缓存分开记。缓存保存的是某次计算,不是永久知识,也不会让上下文容量自动变大。
以下保留旧I gave→her语言例作为同一缓存原则的独立对照,当前视觉主线则固定在新输入blue、下一目标book。
先比较两个相邻时刻。给定 I gave,最后位置的分布用于选择 her;选出后,下一次输入变成 I gave her,此时要预测的是后面的词。直接从头运行第二次前向,旧位置 I 与 gave 又经过了一遍模型。这提出了缓存的问题:能否省掉重复工作,同时保持与完整重算一致?
不能只保留第一次的词表分布,因为它回答的是旧前缀后面是什么。第二次已经有了新的条件,必须得到新的分布。可以尝试保留的是旧位置的中间计算,是否可用则取决于这些位置的依赖有没有改变。
假设用户给了一个包含 $n$ 个 token 的前缀。Prefill 让这个已知前缀通过各层,计算所有需要的状态以及最后位置的 logits。最后位置的分布用于选择第一个新增 token。选择出来之后,decode 把这一个新 token 送入网络,得到用于选择下一个 token 的分布,循环推进。
这两个阶段的工作形状不同。Prefill 可以对已知前缀的位置使用矩阵并行;decode 的新增 token 取决于上一步选择。把生成过程画成很多并排位置,只表示计算图,不能使未知 token 在标准自回归循环里同时可用。一次输入可以容纳很长上下文,也不等于每次新增 token 都能无代价读取它。
7.2 为什么旧 K/V 可以复用
在 causal decoder 中,旧位置不能读取后来追加的位置。若前缀 token、位置编号与位置变换、模型参数均不变,且关闭 dropout 等训练随机性,第一层旧输入与可读集合就未变,旧输出因此不变;第二层收到的旧输入也不变,逐层归纳后,各层旧位置的 K/V 都可复用。只检查第一层 K/V,尚未证明整套缓存合法。
在某一层,已有缓存 $K_{1:t-1}$ 与 $V_{1:t-1}$,新 token 经该层投影得到 $q_t,k_t,v_t$。先追加新 K/V,再计算
$$y_t=\operatorname{softmax}\left(q_t[K_{1:t-1};k_t]^\top/\sqrt{d_k}+M_t\right)[V_{1:t-1};v_t].$$
每层有自己的缓存,新 token 仍须依次走过所有层。
翻译模型的源句固定时,各decoder层cross-attention使用的源K/V也可分别缓存;它们来自encoder表示,不是随目标增长的self-attention KV清单。通常只需当前 query,旧 query 不必缓存来重新输出旧位置。对于 RoPE,要沿用正确的绝对位置索引以及一致的旋转规则;若某种实现随总序列长度动态改变旧位置的变换,简单复用的前提需要重新检查。Cache 也必须属于同一前缀和参数版本,不能把另一条会话的旧 K/V 接过来。
官方实现对逐层缓存、mask 长度和位置对齐的说明可读 Hugging Face Transformers:How caching works;API 随版本更新,复现实验须锁定版本。本章公式采用明确的加性 mask。对于双向 encoder,新增输入会扩大旧位置的可读集合,因而高层旧表示可能改变;若第一层仅投影未变的 token 与位置 embedding,其旧 K/V 仍可能相同,但这个局部例外不能证明跨层缓存合法。缓存是合法复用已有计算,不会自动增加上下文窗口或知识。
DN1 已有本地与 Deepnote 云端等价检查和速度记录;DN2 的文档编码检查另列,均不作为语言能力证据。
假设应用把越来越多日志或视觉位置放进输入,系统先处理整个前缀,再生成几个回答token。要判断显存或延迟,不应只说“attention是平方复杂度”:前缀处理、逐步生成、参数、KV与临时矩阵是不同账目。
7.3 prefill 与 decode 各做什么
prefill已知整段输入,能并行投影所有token、计算合法attention并保存各层K/V。decode每次只有一个新token,要计算它的embedding/层内QKV/FFN/词表头,并用新query读历史K/V。cache省掉旧token的投影、FFN和表示重算;新token的工作和历史读取仍要做。
设一层模型宽d、FFN宽f,忽略bias、激活和归一化,乘加记为一个MAC:prefill n个token的QKV与输出投影约4nd²,FFN约2ndf;密集attention QKᵀ与AV约2n²d MAC(具体causal内核是否跳过上三角另算)。decode一步读t个key时,投影约4d²、FFN2df、交互约2td。若把乘法与加法各算一个FLOP,这些量再约乘2;不能混用计数口径。词表头还可能有d×|V|项。
7.4 KV payload 的单位要写全
设 L 为缓存的层数,B 为批中序列数。每层每条序列保留 n 个位置、H_kv 个 KV 头、每头 d_h 维,K 与 V 各一份,每元素 s 字节;公式前的 2 表示 K、V 两份:
$$\text{KV bytes}=2LBnH_{kv}d_hs.$$
取L=32、B=1、n=4096、H_kv=8、d_h=128、s=2(半精度存储),得到536870912bytes,即512MiB。这只算KV有效数组,不含模型权重、激活、临时buffer、碎片与运行时。完整MHA若H_kv=32则为2GiB;同head维的GQA用8个KV头是其1/4。
若显式保存64个头、n=100000的全scores矩阵,半精度需要 64×100000²×2=1.28×10^12bytes,约1.28TB(十进制)≈1.164TiB;仅单层、batch=1的score张量。这说明朴素物化的压力,不是所有attention实现的显存下限,FlashAttention正是改变是否把整张矩阵写回高层存储。
7.5 同一个attention,算术、容量与搬运分开记
接下来切换计算阶段。单步decode常只有一个新query、分数为1×t;现在讨论已知多个query的prefill或训练,才会出现完整N×N分数表。训练还需要反向传播,prefill通常只做前向并建缓存,不能把这三者的计时与形状混在一起。
朴素实现先算 $S=QK^\top/\sqrt{d_k}$ 并把S写入HBM;下一个阶段读S,做逐行softmax并把P写回;再读P和V计算 $O=PV$。HBM是GPU高带宽显存,不是CPU内存或磁盘。片上工作区更小,不能装整张大表,但能逐块保留当前累计。
分块算法读入一块Q与若干K/V,算出的分数块立即用于更新归一化统计与输出累计,不把完整S或P物化回HBM。它保持密集attention的数学结果,在规定浮点容差内与全量计算一致;没有把一般 $O(N^2d)$ 成对算术变成线性。下面完整展开KV单位、m/ℓ/u重缩放、17/3手算、原论文GPU测量和本课CPU缓存检查;默认课堂用六分钟建立缓存与搬运的资源直觉;T60–T65另有独立的十一分钟账本展开,两者都不压缩本章完整的独立阅读内容。
先限定阶段:下面的完整N×N图属于训练/prefill的多个query处理已知输入。常见单请求单步decode只有一个新query,score为1×t;不能把两者都画成同样的平方临时表。训练还需要反向传播与保存或重算,prefill通常只做前向,decode读取已有KV并追加新位置。
以朴素分阶段实现为例,QKᵀ产生S,softmax产生P,再由PV产生O。S与P可能先写回大容量HBM,再被后续内核读入;Q/K/V、最终O和模型权重也占资源。这里的“朴素”是一种实现安排,不是attention数学定义强制要求保存这些中间张量。
GPU片上工作区小而快,HBM是GPU显存,容量大但搬运有成本。可以选一块query,逐块读取key/value;每个分数块算出后立即用于累计,不把完整S或P写回HBM。Q/K/V与最终O的语义保持不变,改变的是数据何时驻留何处。FA1原算法的具体外内循环与本段“观察一块query”的解释视角要区分;FA2另有线程块并行与工作分配优化,不能混称为同一版循环。
训练反向可以保存每行归一化统计,按需重算小分数块。这样可能多做算术,却少搬运大量中间数据。是否更快取决于硬件、尺寸、精度、批量与内核,不能只从FLOPs下降或上升推出速度。
7.6 FlashAttention为什么不必保存整张热图
softmax一行的输出是 sum_j exp(s_j)v_j / sum_j exp(s_j),其中 s_j 是第 j 个合法 key 的分数。为了稳定,减去已处理分数的最大值 m,定义未归一化权重 $w_j=\exp(s_j-m)$。在同一个基准 m 下,$\ell=\sum_j w_j$ 是权重和,$u=\sum_j w_jv_j$ 是 value 加权和,输出为 $u/\ell$。分块时后面可能出现更大的分数,因此维护 m、ℓ、u 三个量;读新块后:
$$m'=\max(m,\max s_{new}),$$ $$\ell'=e^{m-m'}\ell+\sum_{new}e^{s_j-m'},\quad u'=e^{m-m'}u+\sum_{new}e^{s_j-m'}v_j.$$
最后输出u'/ℓ'。旧贡献和新贡献必须使用同一指数基准,所以旧ℓ与u都要重缩放。这是在线softmax的关键,而不是“只看最大项”的近似。
初始化从第一个有效块开始,或令m=−∞、ℓ=0、u=0并对空块显式跳过;不能直接计算−∞−(−∞)。被mask掉的位置不进入最大值与指数和。整行没有合法key应显式处理或避免,不把NaN当“选择不读”。u为向量时逐分量累计同样成立。
接下来把同一份m/ℓ/u账本用于scores=(0,ln2,ln3)、values=(2,4,8)。分块不需要永久保存每个权重,只需在新块到达时把旧累计统一到新的最大值基准;下表逐项核算。浮点实现允许既定容差,不承诺逐bit一致。
FlashAttention把这个思想与GPU分块、片上存储和反向重计算组织结合,减少高带宽内存读写;仍计算密集合法连接,不等于稀疏attention,也没有把所有成对算术变为线性。GQA减少KV头,cache复用旧计算,FlashAttention减少物化和IO——三个改动可以共存,但作用不同。
7.7 在线累计的两次停点
| 已处理内容 | m | ℓ | u | u/ℓ |
|---|---|---|---|---|
| 前两项 | ln2 | 1/2+1=3/2 | (1/2)·2+4=5 | 10/3 |
| 加入第三项并统一到ln3 | ln3 | (2/3)·(3/2)+1=2 | (2/3)·5+8=34/3 | 17/3 |
前两项的分母按ln2缩放,新项按ln3缩放,所以不能直接相加。先把旧分母与旧加权和都乘2/3,再加新块。一口气算全部时权重为(1/6,2/6,3/6),输出仍为17/3。分别对每块softmax后只保存输出,会丢失块间归一化质量。当前小例两个块的未缩放质量恰好同为3,简单平均恰好也给17/3;因此这个例子用来核对重缩放,不用来证明简单平均必错。对一般分块,必须保留ℓ与u等可组合统计。NumPy复算能够验证这个数值关系,不能充当GPU FlashAttention实现或速度测评。
7.8 多做算术,却少花时间:一项历史测量
FlashAttention 2022 v2物理p6 Figure2左表测量GPT-2 medium attention:A100、序列长1024、head维64、16 heads、batch64,前向+反向。原文的训练与混合精度实现条件属于该历史实验;此处不将结果外推成任何精度、任意尺寸的保证。
| attention子计算指标 | standard | FlashAttention |
|---|---|---|
| 算术 | 66.6 GFLOPs | 75.2 GFLOPs |
| HBM读写 | 40.3 GB | 4.4 GB |
| 时间 | 41.7 ms | 7.3 ms |
算术更多但HBM读写更少,支持“执行时间还受搬运影响”的解释。这里不是完整模型端到端时间,不是本课GPU实测,也不是单步decode结果。Figure1采用另一比较口径,不能把它的数字混进此表。第一讲moving-data/1给过计算/搬运时间下界,本讲补上了具体怎样避免大表往返。
密集attention的合法两两算术仍为O(N²d)。不物化N×N表、减少HBM读写与改变渐近算术复杂度是不同事项。KV payload随已存前缀长度增长;模型权重、FFN、词表头与其他激活另计。exact表示同一数学计算,浮点允许容差差异,不要求逐位相同。
7.9 回到当次更慢的 cache
DN1的标量incremental路径19.95ms、矩阵重算11.46ms,是微型2层、宽8、2头、batch1、float64配置中,16 token prefill之后追加32个预定token的decode合计中位时间,不是每token时间。它没有否定cache的工作量分析,也不证明优化内核一定有同样排名。先用相同预定token和logit容差检查计算,再计时;若用模型自己生成而两条路径选到不同长度,工作量已经不可比。
若要继续研究,分开测prefill、总decode、每步延迟随t的变化与峰值内存;固定模型、精度、硬件、batch和内核版本,给预热/重复与分布。当前课没有运行GQA/FlashAttention速度比较;手算账本与在线softmax是机制解释,不是性能基准。
来源:同版读本第七章;GQA EMNLP2023 §2、FlashAttention2022 v2 §3/Algorithm1/Figure2。单位算例与在线softmax小例为可复算构造;历史毫秒值来自DN1云端G记录。
7.10 延伸:GQA改变共享接口
多query头仍可有不同Q,但每组共享一个K/V头。H_q=32/H_kv=8时,每组4个query头读同一组K/V。KV存储与相应投影减少,Q与每步的读取仍存在;它不是简单给同一张大KV表换压缩文件格式。原GQA论文从T5.1.1等checkpoint转换并继续训练验证质量,不能宣称任意MHA直接替换后无损。
如果瓶颈是显存容量,KV减少可能让更大batch或更长窗口可行;如果瓶颈是小batch的kernel启动/通信,比例减少不一定等于延迟同比例下降。比较要报告H_q/H_kv、d_h、精度、batch、前缀长、生成长与实现。
7.11 窗口容量与实际利用要分开验证
缓存等价只说明省略重算没有改变模型计算。如果原模型本来就答错,合法缓存通常会忠实保留同样的错误。因此接下来需要一个有明确正确答案的任务,而非继续只看logits是否相等。第二章§2.11–2.12的独立配对任务正好提供这样的对象。
第一份材料写“钥匙在赭色盒子”,第二份只把位置改成“灰色盒子”,后续干扰与末尾问题完全相同。正确答案必须不同;一个只依据相同后缀作答的确定模型不能把这一对全部答对。这样,“远处信息是否被用到”有了可检查的要求。再固定事实内容移动其位置,或固定距离改变干扰,才能区分距离、位置与干扰造成的影响。
上下文窗口是接口允许输入多少 token;可用信息是这次实际放进去的内容;有效利用是模型在任务上是否使用了这些内容。把“钥匙在赭色盒子”放在长输入的开头、中间或结尾,并加入受控干扰,才开始接近第三个问题。它仍需多个样本、随机事实、位置对照与清晰判据,不能挑一句失败就宣布某模型没有长上下文能力。
分词还会改变预算。同样长度的中文、英文或代码未必占用相同 token 数;系统提示、用户输入、工具内容以及待生成输出如何共享上限,要按具体接口核对。L5 在这里建立结构和测量方法,关于预训练规模、in-context learning 与检索/记忆系统的进一步设计由后续课程展开。
请先读完整记录,再回答问题。它故意包含更新、撤回与指代;不要只抓住最后出现的颜色词。
09:00 林岑把备用钥匙放在蓝柜;取件人是周禾。 09:10 陈默说红柜空着;这句话只说明红柜,没有改动钥匙。 09:20 林岑通知:把那把备用钥匙改放红柜。 09:30 周禾回复:我还没取;“那把”指备用钥匙。 09:40 林岑撤回09:20的改放通知:它仍在蓝柜,取件人不变。 问题:现在周禾应去哪个柜子取备用钥匙?
按事件时间解释,09:20曾通知改放红柜,09:40撤回这一通知并明确仍在蓝柜,取件人未变。因此人依据文字规则应答蓝柜。这是课程给定的任务真值,不是TinyDecoder输出的答案。“那把”和“它”都指备用钥匙;关于红柜空着的句子不是移动记录。
7.12 四个判断要逐个建立
第一问是实际输入有没有包含09:40与问题;第二问是系统有没有保留相应计算的中间量;第三问是找没找到相关记录;第四问是有没有正确处理撤回与指代,采用当前有效事实。大窗口可以满足第一项,KV cache可以复用某些中间量,二者都不能直接保证后两项。
如果回答红柜,至少有两种解释:输入模板/截断删掉撤回消息,或消息还在但模型错误采用旧通知。先打印实际送入的token与解码文本,可以区分“根本没输入”和“输入后没用对”。然后把关键记录移动到不同位置、保留事件时间和内容,再比较正确性,才开始接近有效上下文问题。若移动时改变了事实时序,已经不只是改变距离。
7.13 本次实际编码与位置
这里特意采用教学字符编码:每个Unicode码点一个token,空格、换行、标点都计入;词表为本段出现的字符加负对照所需“绿”,按字符排序赋ID。没有商用tokenizer,也没有隐含聊天模板或BOS。原文→字符列表→ID的全部内容随结果JSON提供,Notebook可以逐项显示。
本次词表71项,全文含问题共161 token;prefill为141个token。位置141是正文后的换行,问题文字从142开始;随后20个token包含换行及19个问题字符。位置从0计,结束位置不含该端点。下表把09:40整条记录移至开头,其他记录相对顺序不变。
| 事件 | 原区间 | 移动后 |
|---|---|---|
| 09:00 | [0, 25) | [34, 59) |
| 09:10 | [26, 56) | [60, 90) |
| 09:20 | [57, 80) | [91, 114) |
| 09:30 | [81, 107) | [115, 141) |
| 09:40 | [108, 141) | [0, 33) |
图中金色是09:40撤回记录;移动的是完整记录而不是改写时间。末尾问题位置不变。
真实模型要用它自己的tokenizer和聊天模板,再核对输入上限与输出预留;字符串长度不等于token数。左截断可能删早期实体定义,右截断可能删更新或问题,摘要也可能把撤回关系抹掉。位置编码支持计算某个索引,不等于在训练之外的索引能可靠工作。
7.14 几种被统称“记忆”的东西,保存的并不相同
| 机制 | 保存什么/何时进入预测 | 失效时先查什么 |
|---|---|---|
| 参数 | 训练得到的函数,每次推理使用同一组权重 | 没有学过、记忆不精确、事实过期 |
| 当前上下文 | 本次实际输入tokens及计算形成的表示 | 模板、切分、截断、位置或使用错误 |
| KV cache | 同一合法前缀各层已算出的K/V | 前缀、模型、位置或条件是否改变 |
| 外部检索 | 存文档;选中的段落插入本次输入后才作用 | 检索遗漏、过时条目、后续推理错误 |
| 历史日志/摘要 | 应用保存的记录或压缩文本 | 是否真的注入,摘要是否删掉例外和撤回 |
检索到了09:20但没检到09:40,和完整输入后误用09:20,是不同故障;用同一个“记忆不好”遮住它们,会选错修复手段。KV也不是可跨任意会话复用的事实数据库。
7.15 用这段字符流只验证 cache 的计算
我们给未训练的TinyDecoder配置与教学词表相同的vocab大小,喂入上面161个真实字符ID。2层、宽8、2head、每head4维、FFN16、float64、固定种子20261021,无dropout。先prefill记录正文141个token,再逐字追加换行和问题,共20个token;每步比较incremental与完整前缀重算的logits。这里确实接上了可读文本的编码,但随机模型从未学过问答,因此不把任何argmax当蓝柜/红柜能力结果。
| 实际检查 | DN2 CPU结果 |
|---|---|
| full/incremental最大logit误差 | 1.804e-15 |
| 改旧前缀仍用过期cache的最大差 | 0.015632048 |
| 161位置全部KV payload | 41216 bytes |
| 模型是否受训 | 否 |
| 文档问答正确率 | 未评价;蓝柜是人类按规则确定的标签 |
表中1.804×10⁻¹⁵是DN2本地CPU参考值;Deepnote云端同代码保存输出为2.241×10⁻¹⁵,二者都小于本次检查容差10⁻¹⁰。过期cache差在两处均约0.015632048。检查依赖容差与明确对照,不把浮点末位相同作为要求。
因果模型的旧位置不能看新增token,所以在参数、原前缀、位置编号和相关条件相同的确定性推理下,第一层旧表示不变;逐层推下去,每层旧K/V都不变。新query可以读取它们,无须重新投影旧位置。双向encoder追加内容会改变旧位置能看见的信息,不能直接套此证明。
负对照把最早的“蓝柜”改成“绿柜”,仍沿用旧前缀cache,末位置logits便不等于新全文重算。这项改动没有改变最终撤回句“仍在蓝柜”,所以按人类语义规则最终答案仍是蓝柜;数值差异测试的是缓存条件改变,不是答案必须改变。可以复用首个变化位置之前完全相同的缓存,从变化处起重算;不必把未受影响的更早前缀也丢弃。
C = paths.path_c()
print(C['document'])
display(pd.DataFrame(C['spans']))
print(C['full_incremental_max_error'], C['changed_prefix_stale_cache_max_error'])
print(C['moved_document'])   # 事件时间与整条记录一起移动
完整编码、缓存对照和记录移动的实现见§7.18“复核与实现”;先区分计算是否一致与运行是否更快。
7.16 等价检查与速度检查使用不同证据
前面的Path C误差属于161字符文档的随机TinyDecoder检查;§7.9的19.95/11.46ms属于16-token prefill后32步decode的原计时。二者没有在同一批运行里共同产生,因此不能把约2.22×10⁻¹⁵的另一项等价检查或Path C的1.804×10⁻¹⁵贴到那组计时上。
原计时一次预热、五次测量。cache路径含Python/标量循环和逐次拼接分配,完整路径调用NumPy矩阵计算;减少重复算术并不保证微型实现更快。若要在目标硬件验证收益,需要分别测prefill、decode总时间与逐步延迟,保留相同模型、token、精度、batch、预热和测量方法。数值一致性、KV有效字节、进程RSS与延迟分别回答不同问题。
7.17 移动证据,然后诚实地界定能力检查
既有DN2诊断把09:40整条记录移到文档开头,保留时间与内容,总token数仍为161,记录起点从108移到0,问题仍在末尾。按事件时间的答案不变。Notebook显示两份实际文本与位置;它只验证干预正确生成,没有报告随机模型在两种位置的问答准确率。
LAB03既有bit任务是另一个更简单的成对任务:固定其余符号,只改一个早期线索,最后QUERY要求输出0/1。它不包含自然语言撤回或指代。DN1.1的length/fraction/seed同源贯通数据、位置表与评价;常数基线50%准确、成对全对0%,仍没有已训练有效上下文模型成绩。
真正的能力评测需要已训练checkpoint、明确训练长度/位置范围、独立测试模板、成对事实标签。先固定总长移动证据,再固定距离改变干扰量;记录输入实际token、事实正确率和一对全对。缓存测试保持logits相同只能排除实现不一致,不能证明理解。把这个URL交给Agent后,学生可以自然地追问“缓存都在,为什么撤回还可能没用上”,再返回检查它究竟属于输入、计算还是事实使用层。
来源:原R7.1第七章、S36–S41扩展、LAB03 G;当前计算入口为T50–T51;本节记录为教学构造,编码/位置/cache为DN2 CPU真实机制验证;计时为DN1原云端记录;自然问答与bit任务能力评测未执行。
7.18 复核与实现
返回LAB03的“路径C · 材料放得下,不代表采用了当前事实”,核对原文、字符ID、移动记录与过期cache负对照。
def path_c():
    text=document();moved=document([4,0,1,2,3]);vocab=sorted(set(text+'绿'));ids={c:i for i,c in enumerate(vocab)}
    encode=lambda s:[ids[c] for c in s]
    tokens=encode(text);model=old.TinyDecoder(seed=20261021,vocab=len(vocab));split=text.index('\n问题:')
    full,_=model.full(tokens);_,cache=model.full(tokens[:split]);errors=[]
    for t in range(split,len(tokens)):
        actual,cache=model.incremental(tokens[t],cache,t);errors.append(float(np.max(abs(actual-full[t]))))
    changed=text.replace('蓝柜','绿柜',1);changed_tokens=encode(changed)
    _,oldcache=model.full(tokens[:-1]);stale,_=model.incremental(changed_tokens[-1],oldcache,len(tokens)-1)
    fresh,_=model.full(changed_tokens);delta=float(np.max(abs(stale-fresh[-1])))
    assert max(errors)<1e-10 and delta>1e-10
    def spans(s):
        return [{'event':t,'start_zero_based':re.search(r'(?m)^'+re.escape(t)+' ',s).start(),'end_exclusive':re.search(r'(?m)^'+re.escape(t)+' ',s).start()+len(t+' '+body)} for t,body in DOCUMENT_RECORDS]
    return {'identity':'DN2 untrained TinyDecoder mechanism on explicit teaching character encoding, NOT document QA',
            'document':text,'moved_document':moved,'question':QUESTION,'human_rule_answer':'蓝柜',
            'encoding':'one Unicode code point -> one sorted-vocabulary ID; whitespace/newline/punctuation count; no BOS/template added',
            'vocab':vocab,'token_ids':tokens,'token_count':len(tokens),'vocab_size':len(vocab),'prefill_tokens':split,
            'spans':spans(text),'moved_spans':spans(moved),'moved_token_count':len(encode(moved)),
            'full_incremental_max_error':max(errors),'changed_prefix_stale_cache_max_error':delta,
            'cached_bytes':int(sum(c['K'].nbytes+c['V'].nbytes for c in cache)),
            'model':{'layers':2,'heads':2,'width':8,'dtype':'float64','trained':False,'seed':20261021},
            'task_prediction':'not evaluated; human answer is not a model prediction'}
7.19 资源改善之后,还要回到事实
KV cache与FlashAttention可以组合:前者避免因果生成中的旧前缀重算,后者改变attention内核的物化与搬运。能装下、更快、钥匙事实答对仍是三个分别验证的指标。随机TinyDecoder的数值等价不会提供问答能力;真实任务需要受训模型和配对评价。
第八章 回看技术转折,继续提出问题
最后回到信息、机制、代价与证据之间的关系。不新增一张架构目录,而是把几个已发生的判断迁移到新的问题上。
8.1 回到开场,再看研究改变了什么
回到“我昨天给了他一本书”:原先的词典草稿需要决定him、gave、a book和时间位置。结构分析让这些责任可见,共享表示让相关经验有机会合用,状态让次序进入计算,逐次读取让不同输出步重新选择源信息。完整系统仍须形成合法目标条件,并把分布变成直到EOS的表达。一个架构名不能直接保证关系正确;研究需要知道旧系统已经做到哪里,什么证据使新的选择值得投入。
2014年的源序反转没有增加事实,却改变了部分依赖路径;相近时期的动态读取把“保存哪些表示”和“当前从哪里取信息”分开。2017年的全attention进一步替换序列计算骨架,需要显式加入位置、因果范围和完整block;它的价值来自机制与带条件的翻译结果共同支持。2020年实际系统仍可以选择Transformer encoder与RNN decoder,因为源编码和逐步生成承担不同职责。
视觉前缀在文字之外加入当前图像的证据,训练才使这条通路有机会被正确使用。KV缓存与FlashAttention则保留数学目标,分别改变跨步复用和一次读取的内存安排。结构、训练、信息与执行各有可研究的变量,也各需适合的证据。
假设回到2017年,你面对已有强循环和卷积系统:什么机制使全attention值得尝试,原表的哪项证据最相关?若任务改成逐步生成且延迟敏感,编码器与解码器是否仍应同选一种骨干?可以依据已见的连接路径、合法并行范围、质量与计算条件提出不同答案。好的选择需要说明成立条件,也要知道什么结果足以改变它。
8.2 阅读与实验怎样继续
先从自己尚未想通的一处进入完整主题:源序为什么影响学习、一个block怎样完成预测、图像怎样成为合法条件,或同样数学计算为何耗时不同。把主题URL与自己的问题交给Agent,再回原Notebook核对推理、修改一个条件或读取保存结果。阅读不要求先运行全部实验,新运行可在个人副本中继续。
8.3 什么结果会让你改变判断
假设你倾向固定状态模型,因为长期流式输入的 KV 存储增长过快。下一步应测量相同服务预算下的内存、首 token 延迟、稳定 decode 吞吐,以及任务是否要求精确回查早期细节。若固定状态节省内存却丢失关键事实,结果支持的是特定成本—能力取舍,不是“新模型更先进”或“旧模型过时”。若任务只依赖短期统计,全 attention 的直接回查能力也可能没有被用到。
一个可执行的研究练习是把路线 C/G 的远处事实任务分成两类:只需保存一个独立事实;需要在许多事实中按当前 query 选择一条。保持 token 数、标签分布与训练预算尽量一致,分别测距离与事实数量。前者偏重保留,后者还要求选择性检索。报告完整结果,包括没有按预期胜出的模型;再解释差异究竟更符合容量、优化、读取接口还是训练分布的假设。
继续阅读时,每篇只先带一个问题。Sutskever 2014:不增加源信息,为什么反转可能改善优化?Bahdanau 2014/2015:动态 context 改了哪条信息接口,长度结果怎样支持它?Transformer 2017:并行性、短路径与翻译结果分别由什么证据支持?FlashAttention 2022:数学目标不变时,哪些硬件读写可以省掉?Mamba 2023/2024:输入依赖选择解决了什么受控任务,哪些更广泛结论还需要额外实验?
把答案写成“我选择哪种计算接口、因为哪条证据、在什么条件下愿意改选”。这比按年代背架构名单更接近本讲要训练的研究能力。
8.4 选择一条能改变理解的实验路线
七条路线是可选择的学习路径,不是新增的统一必做作业。每条都先完成一个最小正确性检查,再进入任务表现或研究扩展。详细输入、配置、运行方法、既有验证记录与待执行设计见实验实施方案。理论说明留在读本,实验页用于真正修改变量、执行和比较。
| 路线 | 先读到哪里 | 最小产物 | 能回答的问题 |
|---|---|---|---|
| A 表示与局部上下文 | 第一章 | 窗口样本对、共现矩阵、表示对照 | 改窗口究竟改变了什么统计? |
| B LM 与生成 | 第二章 | 同口径 NLL/PPL 与生成样本 | 预测质量和解码选择怎样分开? |
| C 长依赖与门控 | 第二章 | 数据捷径检查、梯度与距离曲线 | 模型是否必须利用远处信息? |
| D Seq2seq 与解码 | 第二、三章 | 完整概率树、beam 轨迹与输出 | 是模型分布还是搜索造成差异? |
| E Attention 与位置 | 第三、四章 | Q/K/V、mask、权重和输出 | 匹配、内容与合法连接各起什么作用? |
| F 完整 block | 第四章 | 两头、FFN、残差、norm 的中间量 | 一个位置怎样完成整层更新? |
| G 缓存与有效上下文 | 第七章 | logits 差异、缓存量、分阶段计时 | 复用是否等价,长输入是否真正有用? |
A 从数据而不是散点图开始。 用小语料、固定 tokenizer 和词表,分别改变窗口半径或方向,累计共现并做 PPMI/SVD。固定语料、频率处理和维度,保存哪些训练对改变了、哪些词的邻居改变了。把两个 bank 的固定词向量与加入局部上下文后的表示分开,未训练的上下文组合只能说明接口变化。配套最小实现可在 CPU 上运行,不需要下载大 embedding;若另用预训练向量,须记录语料与版本,避免把外部知识归因于这几句教学语料。
B 让模型比较与采样比较分别发生。 对 n-gram、固定窗口网络与 RNN 使用相同划分、词表、EOS/PAD 口径。先保存保留集的总 NLL、token 数与 PPL,再固定参数改变温度、greedy 或其他采样规则。输出既包括指标,也包括固定前缀的生成文本。CPU 小模型足够检验流程;PPL 的微小差别要结合种子和有限测试集解释,不能把一次排序推广成架构结论。
C 先证明答案不在后缀里。 生成独立均衡的首位标签,在中间放无关干扰,最后用 QUERY 要求返回首位。为相同干扰后缀配上相反的首位和标签,配对样本留在同一数据分区。只看后缀的确定模型不能同时答对配对中的两个样本,这是一条直接的捷径检查。随后比较 RNN 与 LSTM 的解析/数值梯度、短距离学习,再扩大距离。固定训练样本数、更新步数与种子,并记录参数量差异;裁剪开关单独变化。几步训练仅能检查优化管线,长度曲线需要更完整的多种子训练预算。
D 把每条被剪掉的路留下来。 先穷举有限概率树验证完整路径概率和为 1,再运行 width 1 与 width 2,保存每轮候选和被保留前缀。独立搜索扩展树中 .210、.225、.250 分别对应 greedy、beam 2 与穷举最优;实现还可以用其他小树覆盖“beam 恰好找到最优”的情形,不能混写它们的数值。接入小 seq2seq 时,固定参数比较 teacher-forced loss 与自馈输出,明确 EOS、最大长度和长度惩罚。CPU 足够做小任务;完整翻译基准复现不是理解搜索的先决条件。
E 与 F 从手算过渡到张量。 E 固定输入参数,依次只改 query、value、mask 和位置;同时保存权重与读出,检查被遮位置的内容不能影响当前输出。F 接上第二个 head、输出投影、FFN、残差与 LayerNorm,检查每个张量来源和形状。两条路线都可在 NumPy/CPU 上迅速完成,适合先建立计算信心。随机 forward 与有限差分是数学实现检查,不能替代训练后能力评价。
G 先保证结果相同,再问能否更快。 同一个 causal decoder 在 eval 条件下,分别整段重算和增量缓存,保持 token、位置规则与参数相同。保存逐步 logits 最大差异、生成序列和每层 cache 长度。计时分开 prefill 与 decode,记录精度、设备、batch、预热和输出长度;一个低效的 Python 增量循环可能比矩阵化全前缀更慢,这不反驳缓存避免重复计算的数学事实,而是说明实现常数和硬件利用同样重要。有效上下文测试另用确实需要远处事实的任务,并增加事实位置与干扰类型对照。
配套材料保留已有本地最小运行记录,覆盖实现检查与部分小规模训练;这些记录对应各自的原实验配置,应按实际任务与训练范围解释。C 的短训练不支持“LSTM 一定更会记忆”;G 的未训练 decoder 支持缓存正确性检查,不支持语言能力结论。原有 Deepnote 项目与 Notebook 身份保留,DN1/DN1.1 的云端运行与 DN2 的阅读扩展、只读诊断分别记录。本地输出、历史输出与未来完整实验要保持各自身份。