visual-condition-use.md · 可读全文
这里保留原文的中文、公式标记、代码和链接。可直接交给 Agent 读取,也可选取下方原文复制。此入口返回 HTML;原始 .md / .py 文件仍保留,完整候选包同时包含 UTF-8 原件。
# 路径 B:换图后分布变了,模型是否看懂了
课堂接续:[T44](https://codingai-lec05.pages.dev/classroom/T44.html?step=b0) · [T45](https://codingai-lec05.pages.dev/classroom/T45.html?step=b0) · [T46](https://codingai-lec05.pages.dev/classroom/T46.html?step=b0) · [T47](https://codingai-lec05.pages.dev/classroom/T47.html?step=b0) · [T48](https://codingai-lec05.pages.dev/classroom/T48.html?step=b0) · [T49](https://codingai-lec05.pages.dev/classroom/T49.html?step=b0)。连续读本:[第6章](https://codingai-lec05.pages.dev/lecture.html#chapter-6);本主题提供独立定义、例子、代码与来源。
“我昨天给了他一本书。”没有说明封面颜色。即使准确翻译整句,也不能据此断言blue;未知不是计算错误。现在明确给定一张同一事件的教学情境图:男性接收者收到一本蓝封面书。图像提供可见颜色和场景,中文仍提供昨天及说话者角色;单张图不能独自证明事件发生在昨天或谁是说话的我。
这时任务也明确改变为:**结合这句话和图片,用英文描述这次给书,并补充封面颜色。** 在这个新任务下可以选择参考描述 `I gave him a blue book yesterday.`。若任务仍只是忠实翻译原文,擅自添加blue就不是同一个评价目标。红封面控制图保持事件安排,主要改变封面颜色,水彩纹理有轻微变化,不能称为逐像素唯一差异;它用于提出可检验预期,没有新的模型准确率。
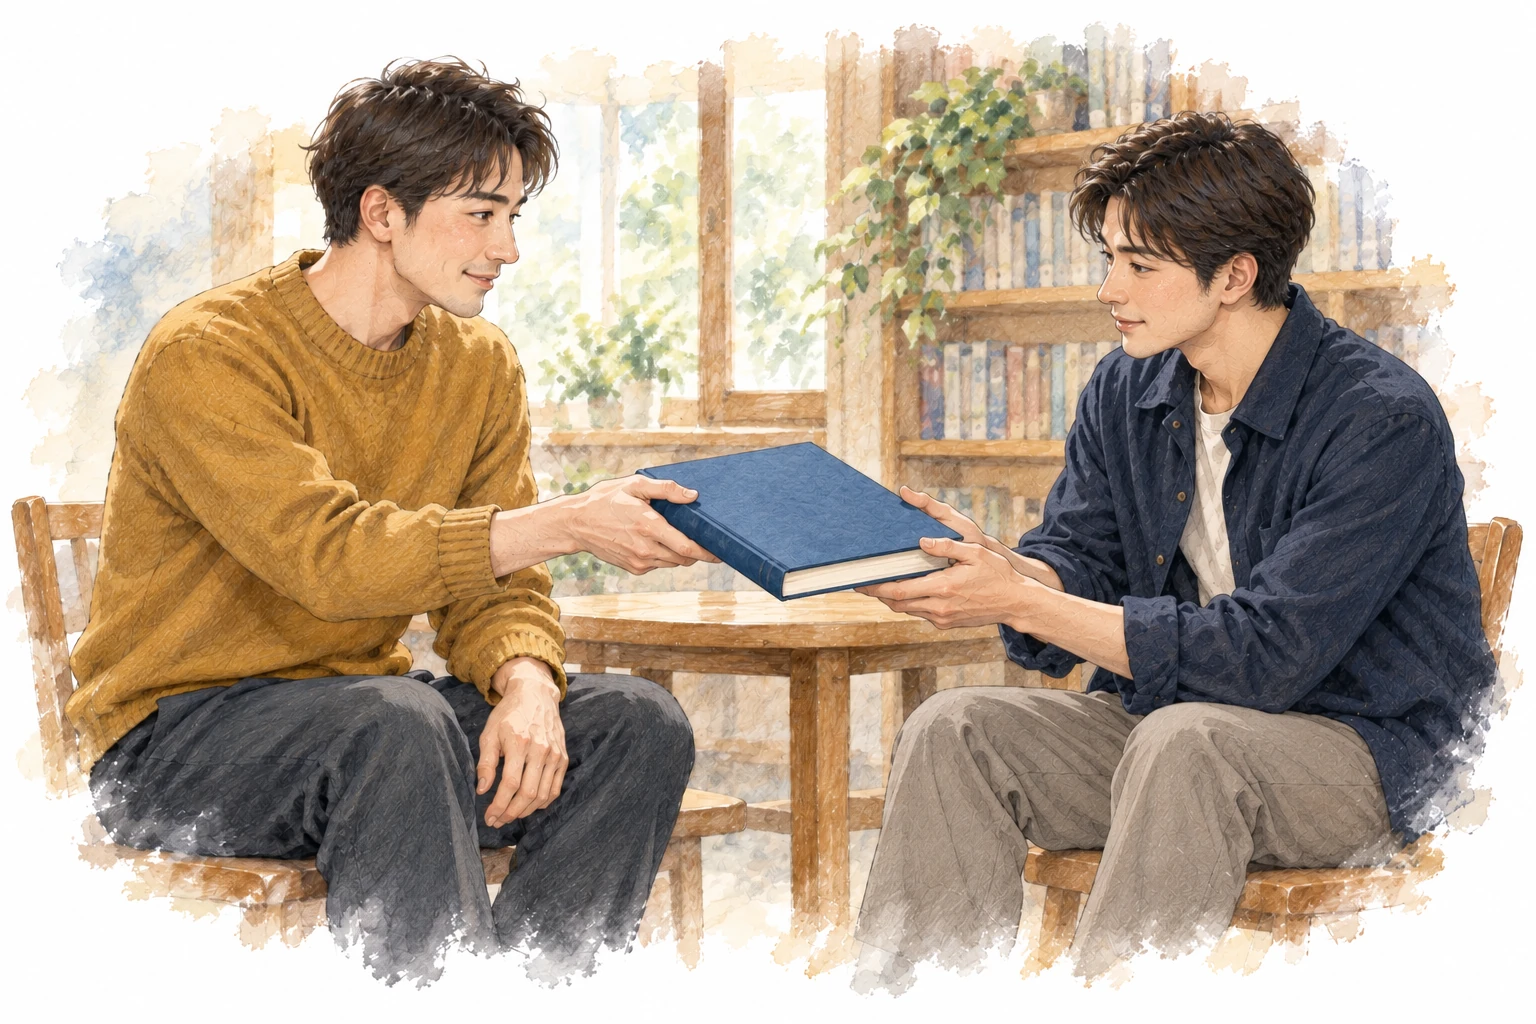
同一蓝图覆6×4网格,四个展示裁片确实裁自该图。24格是解释局部像素到序列的教学选择,不是LLaVA实际视觉token配置;一本书可以跨多格,一格也可能混合多个对象。裁片先经视觉encoder形成可含全图上下文的表示,再投影到语言模型宽度。画一列格子只是接口,不能冒充已经识别出对象。
这里采用LLaVA v2的视觉前缀路线:视觉表示、任务问题、中文和合法英语前缀进入语言decoder。当前英语前缀为 `I gave him a`,**a位置的query**可读取此前视觉与文本位置以及自己,blue尚在输出候选端。经完整层与词表头选择blue后,下一步把blue接回,blue行再预测book;继续生成yesterday、句号与EOS。这样书的颜色确实经过了“条件→当前表示→词表预测→反馈”的链,而不是让还未生成的blue先参与自己的预测。
语言部分是合并序列上的causal self-attention,视觉encoder则可处理整张已知图片;两种可见边界不同。采用视觉前缀也不等于先把图像人工写成标签,更不等于一个CLIP相似度分数。
换蓝封面为红封面,预期颜色词相应变化;只改不相关背景,预期给书关系与颜色保持;以不透明灰色封套遮住封面,则应承认证据不足;封套不是书本的灰色封面。这三项是待执行的事实使用控制,不是已得到的能力结果。下面另行保留LAB14受训几何问答和LAB03随机cross-attention的完整样本、数值和代码,它们分别回答不同问题。
[阅读本主题](https://codingai-lec05.pages.dev/course/knowledge/visual-condition-use.html) · [返回实验](https://deepnote.com/workspace/ise3309jingao-5ba66b0a-4283-4f5a-ae06-3f68d3201e99/project/Fall-26-Lecture-05-841ec8e7-e352-4840-b628-d3742b03d6d0/notebook/LAB-03-Transformer-9c5b3d45acdb438a8e7df1dc6cb97e40?utm_content=9c5b3d45acdb438a8e7df1dc6cb97e40&utm_source=openai&utm_medium=mcp&utm_campaign=openaimcp&utm_term=get_notebook) · [与Agent共读全文](https://codingai-lec05.pages.dev/course/knowledge/visual-condition-use.md.read.html)
读本:[ CLS 03 · 生成、视觉条件与上下文 ](https://deepnote.com/workspace/ise3309jingao-5ba66b0a-4283-4f5a-ae06-3f68d3201e99/project/Fall-26-Lecture-05-841ec8e7-e352-4840-b628-d3742b03d6d0/notebook/CLS-03-719b25c7c5b64687998ba9c19d2f6776?utm_content=719b25c7c5b64687998ba9c19d2f6776&utm_source=openai&utm_medium=mcp&utm_campaign=openaimcp&utm_term=get_notebook),查找“路径 B:换图后分布变了,模型是否看懂了”;实验中查找“路径B · 换图后分布变了,模型是否看懂了”。
<span id="visual-condition-use-s01"></span>
## 视觉前缀怎样参加同一语言计算
当前视觉前缀接口已在上面从同图裁片、投影和合法a行接通到blue,再接blue→book。原LLaVA v2首轮允许图像在问题前或后;本主题选图像在前,视觉encoder可以处理已知全图,语言decoder保留因果边界。视觉位置并不等于物体标签,投影也不是人工翻译成“蓝书”。
### 旧问答接口的独立对照
以下原The book is→blue例完整保留,任务是颜色问答,合法前缀不同于当前扩展描述任务。
这个独立旧问答采用LLaVA原论文v2的视觉前缀接口:图像经过视觉encoder得到一列视觉表示,投影到语言隐藏维度,作为语言decoder的视觉前缀,再接问题与合法答案前缀。原论文首轮允许图像在问题前或后;这里选图像在前,不把它画成所有VLM唯一的格式。
视觉encoder中的位置可读取整张已知图像,因此一个位置的表示不等于一个孤立物体。语言decoder按序列因果规则处理这些表示。假设已知前缀是 `[视觉位置…] [问题:书是什么颜色?] [答案前缀:The book is]`,此刻is位置要预测blue。从is这个最后合法前缀位置产生query,读取不晚于该位置的视觉、问题与已知答案位置的K/V,**包括该位置自己**;再经后续层与词表头预测颜色词。待预测的blue只作为这一步的训练标签,尚未进入这一步的合法输入。下一步若接入blue,它才成为预测终止token等后继内容的条件。
这一层的Q/K/V来自合并后的同一序列,因此是causal self-attention。视觉条件不必先转换成“红书”“人物”等标签,也不是一个CLIP相似分数。图像prefix可以含许多位置;每层都有自己的投影、读取与后续变换。视觉encoder全可见与语言decoder因果可见是两种不同边界,不可画成一张没有边界的全连接图。
<span id="visual-condition-use-s02"></span>
## 三种patch数量,分别属于三种设计
224×224图像按16×16切分时有14×14=196块,每块原始RGB像素有16×16×3=768个值。若采用原ViT式CLS聚合,可能在196个patch之外加一个CLS,成为197行;无CLS均值池化是另一种设计。经过视觉encoder之后,每行可含全图上下文,token不等于物体。
原LLaVA采用CLIP ViT-L/14,实际视觉token数取决于其分辨率与配置,不能把上述196贴给它。给书情境图用6×4教学网格标出24格,实际展示中央四个由同图导出的真实裁片;它只解释从同一图的局部像素到表示的过程,不冒充CLIP ViT-L/14的配置。本课LAB03则进一步简化:每块只取RGB均值与x/y共5维,再做固定随机投影。这不是训练ViT的patch embedding。原图、真实切片与模型处理后的表示需要分开读。
<span id="visual-condition-use-s03"></span>
## 训练职责:什么更新,哪些位置计损失
冻结参数不等于跳过前向:阶段一的视觉encoder与语言模型仍处理输入;阶段二视觉encoder仍前向但冻结。当前监督中a输入预测blue,blue输入预测book,图像和用户条件不按同样方式计算答案loss。
|原LLaVA v2阶段|视觉encoder|投影|语言模型|监督位置|
|---|---|---|---|---|
|阶段1,对齐|冻结|更新|冻结|assistant答案与终止token|
|阶段2,指令微调|仍冻结|更新|更新|assistant答案与终止token|
图像、系统/用户问题提供条件,不作为同样的目标词逐项计答案loss。CLIP图文对比训练学习匹配关系;这里学习的是 `p(answer | image, question)` 的条件生成。冻结已训练视觉encoder可复用已有视觉表示,不能把冻结随机投影也称作拥有视觉知识。这是原LLaVA的流程,不是所有VLM都必须遵循的训练法。来源:[LLaVA v2物理p4 Figure1/§4.1、p5 Table2](https://arxiv.org/pdf/2304.08485v2),[第三讲P65](https://codingai-lec03.pages.dev/course/pages/l3-r2-p65.html)。
<span id="visual-condition-use-s04"></span>
## 已训练能力:第三讲的受控像素问答
第三讲[P54 state1/LAB14保存记录](https://codingai-lec03.pages.dev/course/pages/l3-r2-p54.html)使用720张训练图、180张留出图,每图数量/左色/右形三类问题,共2160/540图问对。输入实际RGB像素与问题模板ID,不是直接输入属性真值。下面引用2026-09-22本地CPU保存结果,
|条件|数量|左色|右形|总体|
|---|---:|---:|---:|---:|
|图+问,已训练视觉模型|100%|100%|100%|100%|
|问题only,另行训练的模型|50%|33.33%|50%|44.44%|
|零图,既有视觉模型输入控制|50%|33.33%|50%|44.44%|
|循环错配图,既有视觉模型输入控制|83.33%|50%|0%|44.44%|
问题only与零图不是同一个训练干预;循环错配也不是独立随机配对。错配部分保留数量关系,却系统改变形状,分项结果不能用相同总体覆盖。44.44%来自此任务分布,不是七类均匀随机猜测的1/7。这些结果支持有限受控任务中训练后的像素利用,不是自然图像通用问答,也不是LLaVA成绩。
<span id="visual-condition-use-s05"></span>
## 另一条通路:本课未训练的cross-attention实验
下面切换到LAB03已存在的湖边图与bank图。给书图用于提出“当前实例缺少什么事实”;这两张图用于检验固定数值通路。不能把一幅图的实验结果贴到另一幅图,也不能把该随机cross-attention实验拼成上面的LLaVA视觉前缀实现。
图A里,一位戴帽子的人坐在湖边长椅上,旁边有一只狗;图B由两幅场景组成,一侧是在银行柜台交接纸币,另一侧是在河岸边读书。它们是课程已有的情境插画。下面把两张实际图片文件交给同一个数值接口,语言前缀都固定为 `a scene`。
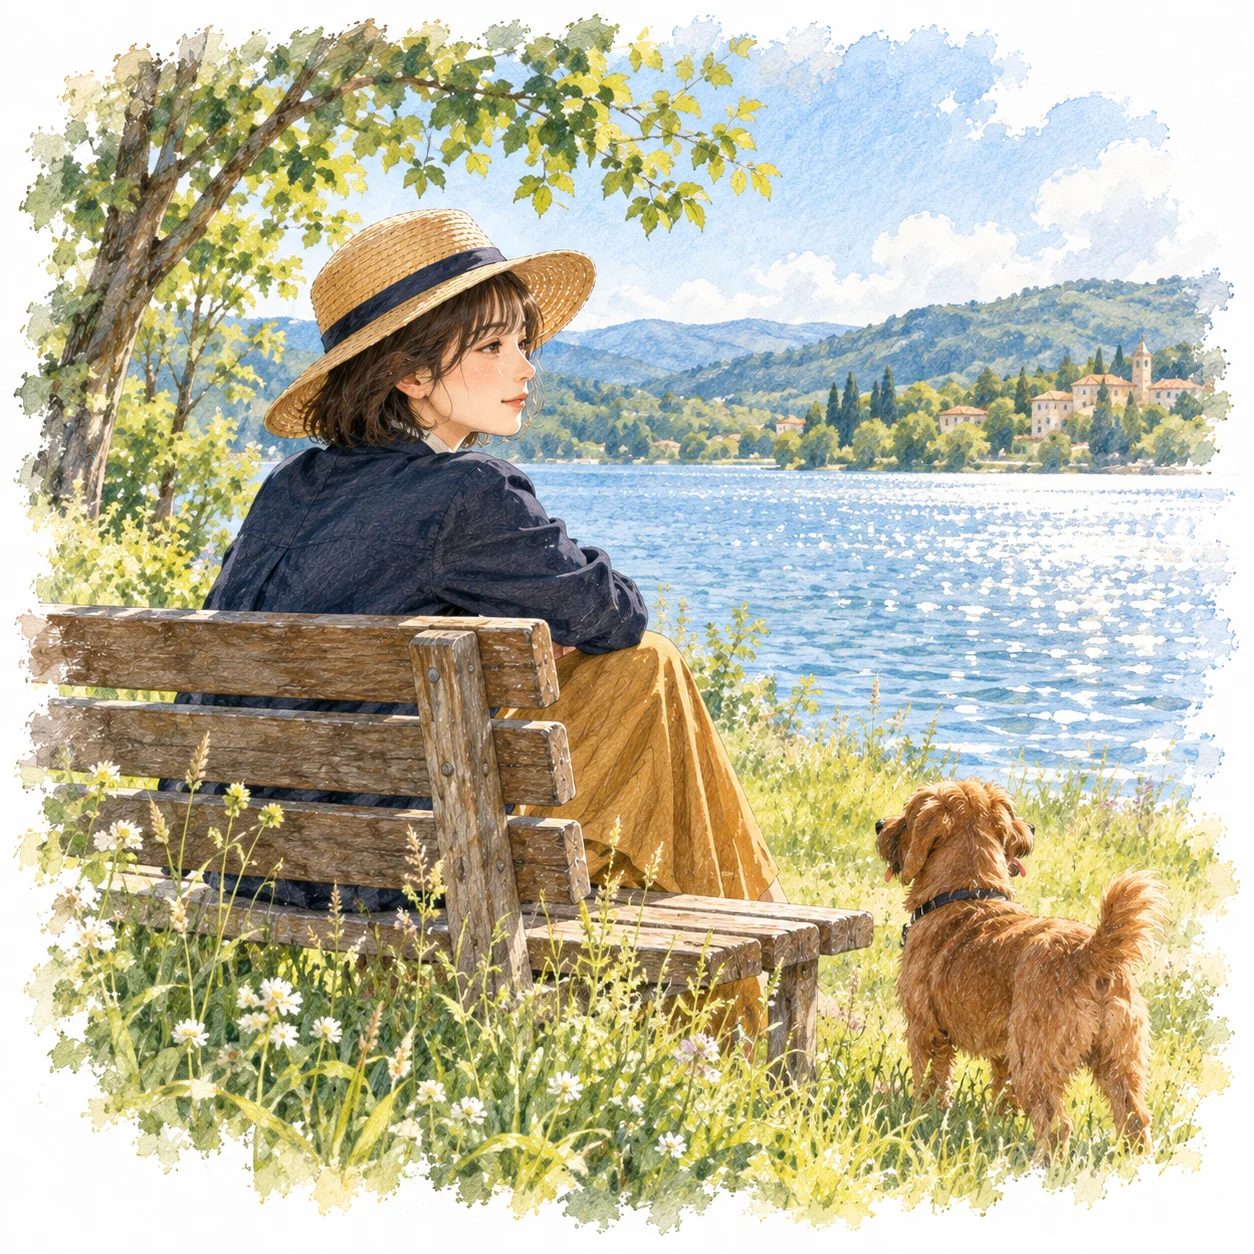
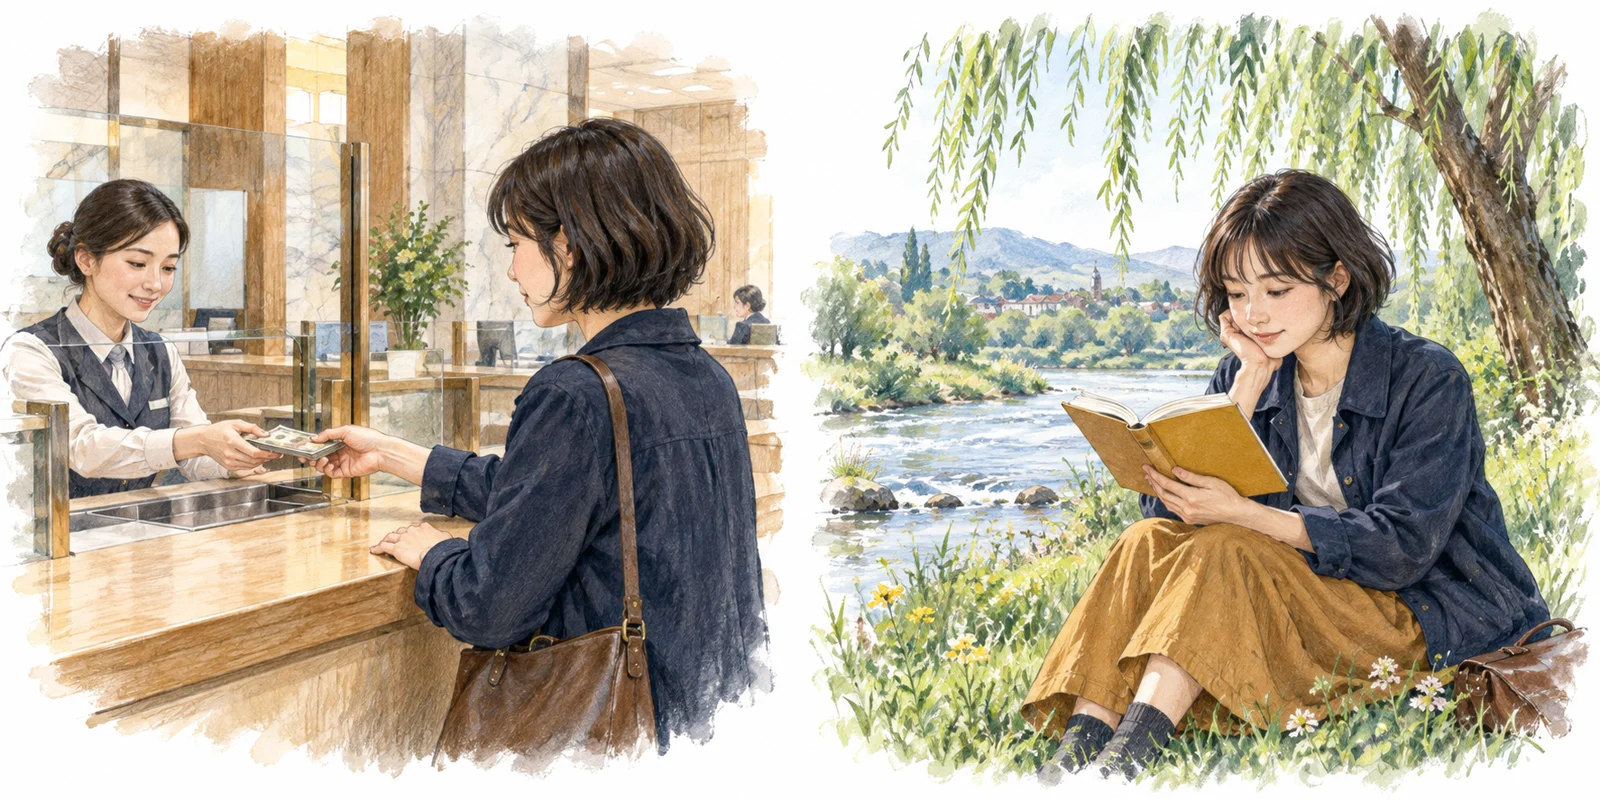
读图任务:先由人指出一条可见事实,再查模型输出是否真在检验它。“图片不同”只是干预条件,“人旁边是否有狗”才是一个可以定义正确性的视觉问题。当前六词词表甚至没有dog,不能把它的下一词分布叫成对这条事实的回答。
<span id="visual-condition-use-s06"></span>
## 完整设计与本实验替代物要并排看
在另设的独立cross-attention接口中,pixels切成patch,经视觉encoder产生Z;目标合法前缀经因果语言网络形成query;视觉K/V由Z投影,读取结果加入语言支路,再由词表头预测下一词。这是该实验所参照的cross-attention接口母图,区别于上文LLaVA主路线。当前实验刻意把多数环节换成可查看的轻量量值,**没有训练好的图像描述模型**。
|环节|当前实际实现|能说明什么|
|---|---|---|
|pixels→patch|RGB缩放到224×224,16×16 patch,共14×14=196个|预处理与空间位置可核对;缩放可能改变形状|
|patch→特征|每patch的RGB均值3维,加归一化x/y坐标2维|人工特征,共196×5;没有对象识别器|
|特征→Z|固定随机5×8投影|196×8未训练表示,不是视觉Transformer encoder|
|语言前缀→query|两个token embedding取平均,再乘8×4矩阵|连前缀顺序也丢了;不是完整因果decoder|
|Z→K/V|各乘8×4随机矩阵|196个4维key/value|
|读取→语言贡献|softmax(qKᵀ/√4)V,再乘4×8并加bias|数值条件通路|
|残差→输出|语言向量加视觉贡献,再乘8×6词表头|六类随机分数,不是识别正确率|
所有参数固定于种子20261016。词表为a/scene/river/person/bank/EOS;给向量列取这些名字,不会让随机参数自动学到这些概念。完整系统和当前替代物共享接口关系,所以可以测试依赖和消融;它们不共享能力结论。
<span id="visual-condition-use-s07"></span>
## 换图必须重算哪一些量
固定的是参数、前缀与评分规则;变化的pixels必须重新生成patch、Z、K/V、权重与视觉贡献。只替换展示图片,却继续用旧K/V,会假造“模型不受图像影响”的结果。沿数组核对才能知道实验实际改了什么。
| 条件 | a | scene | river | person | bank | EOS |
|---|---|---|---|---|---|---|
| A on | 0.281995 | 0.156665 | 0.161435 | 0.145756 | 0.117070 | 0.137079 |
| B on | 0.279580 | 0.156957 | 0.161655 | 0.146479 | 0.117072 | 0.138256 |
| A off | 0.138194 | 0.208762 | 0.142520 | 0.203402 | 0.145650 | 0.161473 |
| B off | 0.138194 | 0.208762 | 0.142520 | 0.203402 | 0.145650 | 0.161473 |
实际max|ΔZ|=0.922170018;开分支max|Δlogits|=0.016440292;关分支max|Δlogits|=0.0。
| 张量 | 实际shape |
|---|---|
| features | [196, 5] |
| Z | [196, 8] |
| Q | [1, 4] |
| K | [196, 4] |
| V | [196, 4] |
| weights | [1, 196] |
| read | [1, 4] |
| branch | [8] |
| logits | [6] |
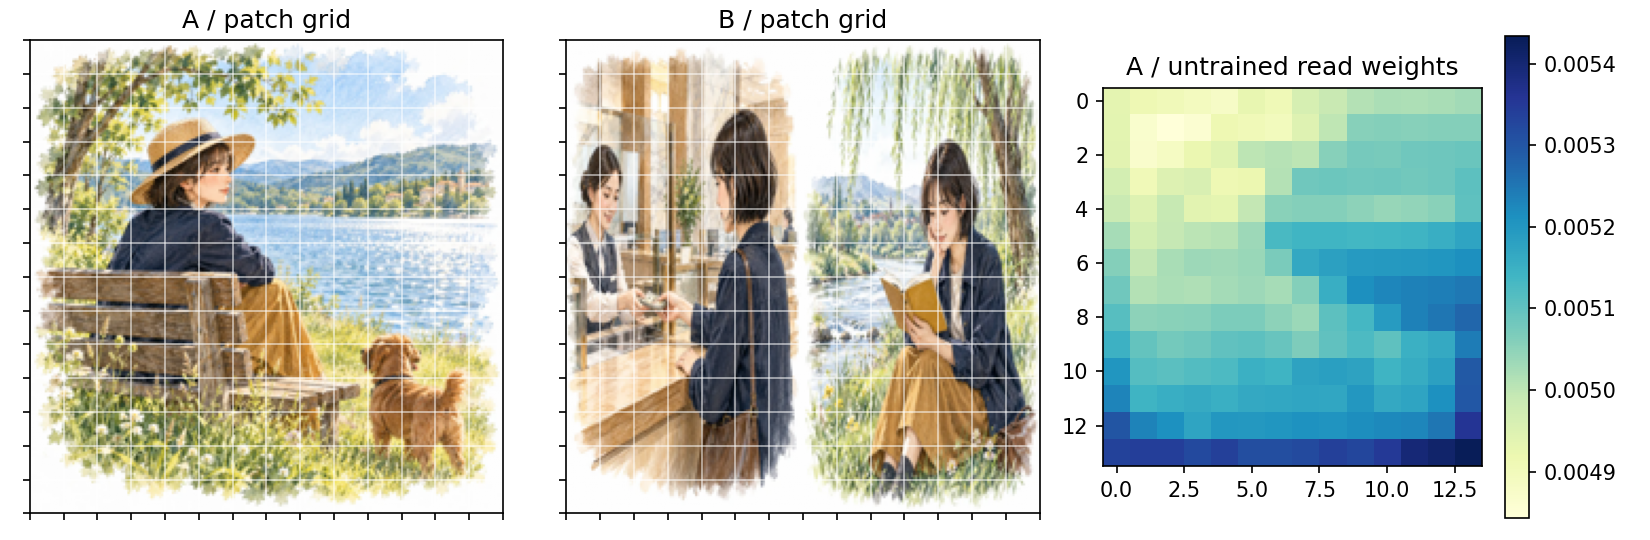
图中每格对应16×16像素的一个patch;热图沿196个位置归一,颜色只表示权重,不能把色块命名为识别标签。
两张图开分支后logits有变化,但两张图的argmax仍都是a;“输出变了”在这里准确指概率/分数变化,不是生成了一句不同且正确的描述。关掉视觉分支以后两张图的logits逐元素相同,支持本实现的这条图像通路已被干净关掉。
读这张表先分清三个对象。词表头给出未归一化分数 $\ell_j$(logits),softmax将它变成 $p_j=\exp(\ell_j)/\sum_k\exp(\ell_k)$,greedy只取概率最大的词。图A/B的a概率约0.281995/0.279580,都仍大于各自其他项,所以分布变了,选择却没变。另一个边界是:给所有logits同时加同一常数,softmax概率完全不变;因此不能从两张概率表唯一倒推出原始logits的最大差。本节的0.016440292来自直接比较两次计算保存的logits,不是由概率表猜出的能力阈值。
门必须放在投影**包含bias之后**:`branch=enabled*(read@O+bias)`,再加到语言残差。只把read设零还会留下bias;把所有attention score设为−∞则会制造未定义softmax。两者都不是这里采用的关闭方式。
分支实现见本主题[“复核与实现”](https://codingai-lec05.pages.dev/course/knowledge/visual-condition-use.html#visual-condition-use-s11);先继续检查这张权重图能说明什么。
<span id="visual-condition-use-s08"></span>
## 集中的热图为什么仍不够
本图有196个位置,完全均匀的权重是 $1/196\approx0.005102$。实际色标约0.0049–0.0054,数值接近这条均匀基线;自动拉伸色标可以制造鲜明色差,不能据此说读取已经高度集中。先读数值范围,再讨论具体位置及其value。
假如随机query偏好亮色patch,热图就可能集中在天空或纸币区域;并不需要识别“河岸”或“银行”。有颜色差异就可以改变Z,继而改变输出。高权重位置传输的是value,value可能已包含周边信息,也可能只是人工颜色坐标;后续输出头还会改变贡献方向。热图是一条中间计算证据,不是语义标签。
遮挡某块后分布改变,能说明这个输入改动影响了系统;遮挡也改变颜色统计和分布,不能独自证明被遮对象是因果识别依据。若把一整条视觉支路关掉后仍有图像差异,先查是否还有未关闭的视觉路径或参数没有固定。若开分支换图完全无差异,可能没重算K/V,也可能头将差异抵消。检查中间Z/K/V与分支向量能区分这两类解释。
<span id="visual-condition-use-s09"></span>
## 同图不同任务,为什么接口不同
整图分类通常把Z池化成一个向量,或让专用CLS位置汇总后接类别头;它只需对整图给一次判断。逐词生成则可能先说人,再说动作,再说地点,每次前缀不同,读取需求可以不同。让某种汇总适合一个分类目标,不代表它能无损保留所有描述细节。
2015年的Show, Attend and Tell已经用CNN空间特征、随目标前缀变化的attention与LSTM生成描述。2017情景的新假设是替换语言骨干及其计算组织,不能把视觉读取本身宣称首次出现。原始ViT常用可学习CLS与位置embedding;本实验的RGB+xy没有复现那套训练。
如果冻结一个**已训练**视觉encoder,只训练适配层/读取接口,通常能降低需要更新的参数与反传开销,但原表示丢掉的信息未必能靠适配器恢复。联合训练允许任务梯度改变视觉表示,可能需要更多数据、显存和优化协调,也可能损伤原能力。“冻结”只有在明确冻结的是何种权重时才有意义,冻结随机encoder不等于拥有通用视觉知识。这些训练方案在本课中作为待做研究设计。
<span id="visual-condition-use-s10"></span>
## 返回四臂检查,再设计真正的事实任务
把本主题URL和你观察到的概率变化交给Agent,可以用日常语言问“它看见了狗,还是只对颜色敏感?”正文足以让回答方指出词表、随机权重与平均前缀的限制。返回LAB03“路径B · 换图后分布变了,模型是否看懂了”,固定参数/前缀,对A/B各运行开和关分支:
```python
B = paths.path_b(ROOT)
display(pd.DataFrame(B['probabilities'],index=B['conditions'],columns=B['vocab']))
print({k:B[k] for k in ['max_Z_change','max_on_logit_change','max_off_logit_change']})
assert B['max_off_logit_change']==0
```
下一项事实评测可用成对图片:相同场景、人物和光照,只有“钥匙在桌上/柜中”这一关系不同,同一问题要求不同答案;评价单题正确率与一对全对,并防止背景或文件名泄漏。遮挡相关对象和无关区域、换图和无图控制分别做。先需一个确实训练过的模型、未泄漏测试集和明确标签;目前两张插画的四臂计算没有提供这类能力成绩。
来源:原R7.1第六章、S31–S35扩展,当前视觉描述入口为T44–T49;LAB03 `mechanisms.py`;[Xu等2015 §3](https://proceedings.mlr.press/v37/xuc15.pdf)、[ViT v2](https://arxiv.org/pdf/2010.11929v2)。插画沿用已有ImageGen来源;概率是既有DN2 CPU机制复算;冻结/适配/联合训练与成对事实任务为未执行研究设计。
<span id="visual-condition-use-s11"></span>
## 复核与实现
下面保留完整分支函数,可对照含bias的关闭位置。
```python
def vision_read(image_path,p,prefix=(0,1),enabled=True):
image=np.asarray(Image.open(image_path).convert('RGB').resize((224,224)),float)/255
patches=image.reshape(14,16,14,16,3).transpose(0,2,1,3,4)
rgb=patches.mean((2,3)).reshape(196,3)
yy,xx=np.meshgrid(np.linspace(0,1,14),np.linspace(0,1,14),indexing='ij')
features=np.column_stack([rgb,xx.ravel(),yy.ravel()]);z=features@p['encoder']
language=p['embedding'][list(prefix)].mean(0);q=language[None]@p['Q'];k=z@p['K'];v=z@p['V']
read,weights=old.attention(q,k,v)
projected=read[0]@p['O']+p['bias']
branch=float(enabled)*projected # gate AFTER bias, BEFORE language residual
logits=(language+branch)@p['head'];probabilities=old.softmax(logits)
return dict(image=image,features=features,Z=z,Q=q,K=k,V=v,weights=weights,
read=read,branch=branch,logits=logits,probabilities=probabilities)
```
<span id="visual-condition-use-s12"></span>
## 同题换图与同图换题,怎样评价事实使用
对同一问题换相关图、错配图或无图,检查目标事实准确率及一对都对;对同一图改变问题,检查模型是否转向所问属性。句子改变只说明行为敏感,不能证明改变方向正确。答案应限于可见证据,图像不能保证镜头外物体、人物意图或过去事件。背景、文件名和模板泄漏也要控制。
<span id="visual-condition-use-s13"></span>
## 其他接口为什么值得保留
2015年Show, Attend and Tell用CNN空间特征、动态读取和LSTM生成字幕;它说明视觉读取并非2017年之后才出现。Flamingo使用NFNet CNN视觉骨干、Perceiver Resampler与插入语言模型的独立cross-attention,不可拿ViT patch示例标为其原结构。BLIP-2使用Q-Former连接冻结视觉encoder与冻结语言模型,是另一种压缩/桥接选择。它们回答怎样传递视觉条件的不同问题,没有在本课被同时复现。原始来源:[Show, Attend and Tell §3](https://proceedings.mlr.press/v37/xuc15.html)、[Flamingo §2](https://arxiv.org/pdf/2204.14198)、[BLIP-2 §3](https://arxiv.org/pdf/2301.12597)。
图像分辨率与视觉位置数量增大、文档更长,都让当前query需要读取更多材料。下一主题保留预测语义,分开追踪算术、存储与搬运成本。
原课程连续页组:CS231n lecture_7.pdf物理p76–87以同一图完成条件生成直到END,再看成功/失败;该文件页脚April 21, 2025,元数据创建于2026。lecture_8.pdf物理p101–110逐步把同一猫图变成patch与视觉Transformer,页脚April 23, 2026。两文件保留原身份,不合并成同一年份。
<span id="visual-condition-use-s14"></span>
## 相邻知识与复核资源
[路径 A:分数进步了,为什么这一句仍然错](https://codingai-lec05.pages.dev/course/knowledge/teacher-forcing-and-generation.html) · [路径 C:材料放得下,不代表采用了当前事实](https://codingai-lec05.pages.dev/course/knowledge/cache-and-effective-context.html)
[全部主题](https://codingai-lec05.pages.dev/course/knowledge/index.html) · [关键结果JSON](https://codingai-lec05.pages.dev/course/knowledge/data/learning-paths.json) · [只读诊断源码](https://codingai-lec05.pages.dev/course/knowledge/code/learning_paths.py.read.html) · [Seq2Seq完整实现](https://codingai-lec05.pages.dev/course/knowledge/code/seq2seq.py.read.html) · [视觉机制实现](https://codingai-lec05.pages.dev/course/knowledge/code/mechanisms.py.read.html) · [TinyDecoder与cache实现](https://codingai-lec05.pages.dev/course/knowledge/code/legacy_numpy.py.read.html)