cache-and-effective-context.md · 可读全文
这里保留原文的中文、公式标记、代码和链接。可直接交给 Agent 读取,也可选取下方原文复制。此入口返回 HTML;原始 .md / .py 文件仍保留,完整候选包同时包含 UTF-8 原件。
# 路径 C:材料放得下,不代表采用了当前事实
课堂接续:[T50](https://codingai-lec05.pages.dev/classroom/T50.html?step=b0) · [T51](https://codingai-lec05.pages.dev/classroom/T51.html?step=b0)。连续读本:[第7章](https://codingai-lec05.pages.dev/lecture.html#chapter-7);本主题提供独立定义、例子、代码与来源。
本主题采用图文描述任务:中文“我昨天给了他一本书。”与同一事件的蓝封面书图共同提供条件,参考描述为 `I gave him a blue book yesterday .`。现在看同一个生成时刻:刚选中blue,历史已处理到a,下一次送入的新token是blue,接下来预测book。每一层均已保存截至a的旧K/V;blue在第一层产生新Q/K/V,追加本层K/V并读取历史及自己,再把该层输出送给第二层。第二层用自己的投影与缓存重复这一过程;不同层的K/V不能互相借用。
旧位置不能读取后来追加的blue。若旧前缀、位置规则、模型参数和确定性运行条件不变,旧位置的第一层输出不变,第二层输入也不变,逐层可以证明旧K/V仍合法。被省掉的是旧位置的重复投影和后续表示计算;新token的Q/K/V、FFN、输出头以及读取历史都仍要算。图像、问题或中文前缀改变时,相关历史表示也改变,旧缓存必须作废或按确切依赖重新计算。
原encoder–decoder另有cross-attention的源K/V缓存,它来自固定源H,不随目标每新增一个token而增长;这与decoder-only合并序列的self-attention缓存分开记。缓存保存的是某次计算,不是永久知识,也不会让上下文容量自动变大。
知道哪些计算能复用,并不等于模型会采用当前事实。下面切换到原161-token门禁记录任务,完整保留记录、撤回、移动位置、随机TinyDecoder代码与旧计时;蓝柜是按任务规则得到的人类标签,未训练decoder不提供文档理解成绩。
请先读完整记录,再回答问题。它故意包含更新、撤回与指代;不要只抓住最后出现的颜色词。
> 09:00 林岑把备用钥匙放在蓝柜;取件人是周禾。
> 09:10 陈默说红柜空着;这句话只说明红柜,没有改动钥匙。
> 09:20 林岑通知:把那把备用钥匙改放红柜。
> 09:30 周禾回复:我还没取;“那把”指备用钥匙。
> 09:40 林岑撤回09:20的改放通知:它仍在蓝柜,取件人不变。
> 问题:现在周禾应去哪个柜子取备用钥匙?
按事件时间解释,09:20曾通知改放红柜,09:40撤回这一通知并明确仍在蓝柜,取件人未变。因此人依据文字规则应答**蓝柜**。这是课程给定的任务真值,**不是TinyDecoder输出的答案**。“那把”和“它”都指备用钥匙;关于红柜空着的句子不是移动记录。
[阅读本主题](https://codingai-lec05.pages.dev/course/knowledge/cache-and-effective-context.html) · [返回实验](https://deepnote.com/workspace/ise3309jingao-5ba66b0a-4283-4f5a-ae06-3f68d3201e99/project/Fall-26-Lecture-05-841ec8e7-e352-4840-b628-d3742b03d6d0/notebook/LAB-03-Transformer-9c5b3d45acdb438a8e7df1dc6cb97e40?utm_content=9c5b3d45acdb438a8e7df1dc6cb97e40&utm_source=openai&utm_medium=mcp&utm_campaign=openaimcp&utm_term=get_notebook) · [与Agent共读全文](https://codingai-lec05.pages.dev/course/knowledge/cache-and-effective-context.md.read.html)
读本:[ CLS 03 · 生成、视觉条件与上下文 ](https://deepnote.com/workspace/ise3309jingao-5ba66b0a-4283-4f5a-ae06-3f68d3201e99/project/Fall-26-Lecture-05-841ec8e7-e352-4840-b628-d3742b03d6d0/notebook/CLS-03-719b25c7c5b64687998ba9c19d2f6776?utm_content=719b25c7c5b64687998ba9c19d2f6776&utm_source=openai&utm_medium=mcp&utm_campaign=openaimcp&utm_term=get_notebook),查找“路径 C:材料放得下,不代表采用了当前事实”;实验中查找“路径C · 材料放得下,不代表采用了当前事实”。
<span id="cache-and-effective-context-s01"></span>
## 四个判断要逐个建立
第一问是实际输入有没有包含09:40与问题;第二问是系统有没有保留相应计算的中间量;第三问是找没找到相关记录;第四问是有没有正确处理撤回与指代,采用当前有效事实。大窗口可以满足第一项,KV cache可以复用某些中间量,二者都不能直接保证后两项。
如果回答红柜,至少有两种解释:输入模板/截断删掉撤回消息,或消息还在但模型错误采用旧通知。先打印实际送入的token与解码文本,可以区分“根本没输入”和“输入后没用对”。然后把关键记录移动到不同位置、保留事件时间和内容,再比较正确性,才开始接近有效上下文问题。若移动时改变了事实时序,已经不只是改变距离。
<span id="cache-and-effective-context-s02"></span>
## 本次实际编码与位置
这里特意采用**教学字符编码**:每个Unicode码点一个token,空格、换行、标点都计入;词表为本段出现的字符加负对照所需“绿”,按字符排序赋ID。没有商用tokenizer,也没有隐含聊天模板或BOS。原文→字符列表→ID的全部内容随结果JSON提供,Notebook可以逐项显示。
本次词表71项,全文含问题共**161 token**;prefill为141个token。位置141是正文后的换行,问题文字从142开始;随后20个token包含换行及19个问题字符。位置从0计,结束位置不含该端点。下表把09:40整条记录移至开头,其他记录相对顺序不变。
| 事件 | 原区间 | 移动后 |
|---|---|---|
| 09:00 | [0, 25) | [34, 59) |
| 09:10 | [26, 56) | [60, 90) |
| 09:20 | [57, 80) | [91, 114) |
| 09:30 | [81, 107) | [115, 141) |
| 09:40 | [108, 141) | [0, 33) |
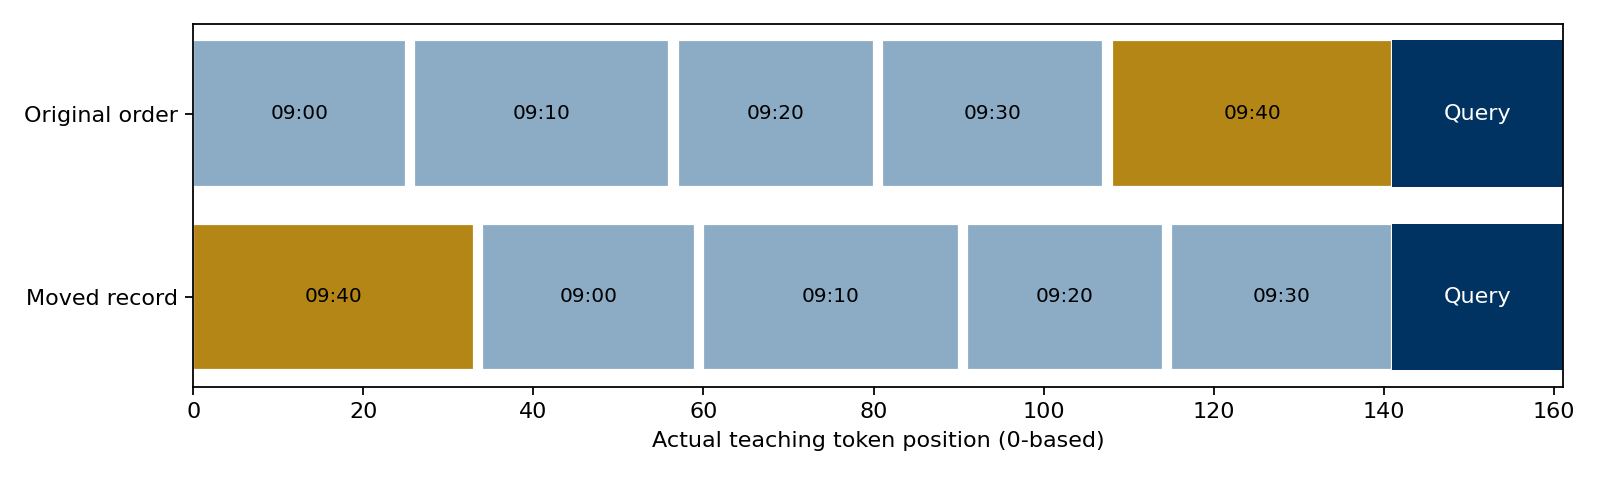
图中金色是09:40撤回记录;移动的是完整记录而不是改写时间。末尾问题位置不变。
真实模型要用它自己的tokenizer和聊天模板,再核对输入上限与输出预留;字符串长度不等于token数。左截断可能删早期实体定义,右截断可能删更新或问题,摘要也可能把撤回关系抹掉。位置编码支持计算某个索引,不等于在训练之外的索引能可靠工作。
<span id="cache-and-effective-context-s03"></span>
## 几种被统称“记忆”的东西,保存的并不相同
|机制|保存什么/何时进入预测|失效时先查什么|
|---|---|---|
|参数|训练得到的函数,每次推理使用同一组权重|没有学过、记忆不精确、事实过期|
|当前上下文|本次实际输入tokens及计算形成的表示|模板、切分、截断、位置或使用错误|
|KV cache|同一合法前缀各层已算出的K/V|前缀、模型、位置或条件是否改变|
|外部检索|存文档;选中的段落插入本次输入后才作用|检索遗漏、过时条目、后续推理错误|
|历史日志/摘要|应用保存的记录或压缩文本|是否真的注入,摘要是否删掉例外和撤回|
检索到了09:20但没检到09:40,和完整输入后误用09:20,是不同故障;用同一个“记忆不好”遮住它们,会选错修复手段。KV也不是可跨任意会话复用的事实数据库。
<span id="cache-and-effective-context-s04"></span>
## 用这段字符流只验证 cache 的计算
我们给未训练的TinyDecoder配置与教学词表相同的vocab大小,喂入上面161个真实字符ID。2层、宽8、2head、每head4维、FFN16、float64、固定种子20261021,无dropout。先prefill记录正文141个token,再逐字追加换行和问题,共20个token;每步比较incremental与完整前缀重算的logits。这里确实接上了可读文本的编码,但**随机模型从未学过问答**,因此不把任何argmax当蓝柜/红柜能力结果。
| 实际检查 | DN2 CPU结果 |
|---|---|
| full/incremental最大logit误差 | 1.804e-15 |
| 改旧前缀仍用过期cache的最大差 | 0.015632048 |
| 161位置全部KV payload | 41216 bytes |
| 模型是否受训 | 否 |
| 文档问答正确率 | 未评价;蓝柜是人类按规则确定的标签 |
表中1.804×10⁻¹⁵是DN2本地CPU参考值;Deepnote云端同代码保存输出为2.241×10⁻¹⁵,二者都小于本次检查容差10⁻¹⁰。过期cache差在两处均约0.015632048。检查依赖容差与明确对照,不把浮点末位相同作为要求。
因果模型的旧位置不能看新增token,所以在参数、原前缀、位置编号和相关条件相同的确定性推理下,第一层旧表示不变;逐层推下去,每层旧K/V都不变。新query可以读取它们,无须重新投影旧位置。双向encoder追加内容会改变旧位置能看见的信息,不能直接套此证明。
负对照把最早的“蓝柜”改成“绿柜”,仍沿用旧前缀cache,末位置logits便不等于新全文重算。这项改动没有改变最终撤回句“仍在蓝柜”,所以按人类语义规则最终答案仍是蓝柜;**数值差异测试的是缓存条件改变,不是答案必须改变**。可以复用首个变化位置之前完全相同的缓存,从变化处起重算;不必把未受影响的更早前缀也丢弃。
```python
C = paths.path_c()
print(C['document'])
display(pd.DataFrame(C['spans']))
print(C['full_incremental_max_error'], C['changed_prefix_stale_cache_max_error'])
print(C['moved_document']) # 事件时间与整条记录一起移动
```
完整编码、缓存对照和记录移动的实现见本主题[“复核与实现”](https://codingai-lec05.pages.dev/course/knowledge/cache-and-effective-context.html#cache-and-effective-context-s07);先区分计算是否一致与运行是否更快。
<span id="cache-and-effective-context-s05"></span>
## 少算了,为什么当次反而更慢
DN1云端参考实现用16token prefill后追加32个预定token,一次预热、五次测量;cached decode总中位19.95ms,完整矩阵路径11.46ms。这是**32步合计**,不是每token耗时,也不是DN2重测的数值。cache参考实现里有Python/标量循环、逐次拼接分配,完整路径则调用NumPy矩阵计算;减少重复算术不保证这个微型实现更快。
数值一致性、KV数组字节、累计进程RSS、理论成对运算和实际延迟分别回答不同问题。下一主题把GQA与FlashAttention放在资源账本里;二者也不是“cache的别名”。
<span id="cache-and-effective-context-s06"></span>
## 移动证据,然后诚实地界定能力检查
既有DN2诊断把09:40整条记录移到文档开头,保留时间与内容,总token数仍为161,记录起点从108移到0,问题仍在末尾。按事件时间的答案不变。Notebook显示两份实际文本与位置;它只验证干预正确生成,**没有报告随机模型在两种位置的问答准确率**。
LAB03既有bit任务是另一个更简单的成对任务:固定其余符号,只改一个早期线索,最后QUERY要求输出0/1。它不包含自然语言撤回或指代。DN1.1的length/fraction/seed同源贯通数据、位置表与评价;常数基线50%准确、成对全对0%,仍没有已训练有效上下文模型成绩。
真正的能力评测需要已训练checkpoint、明确训练长度/位置范围、独立测试模板、成对事实标签。先固定总长移动证据,再固定距离改变干扰量;记录输入实际token、事实正确率和一对全对。缓存测试保持logits相同只能排除实现不一致,不能证明理解。把这个URL交给Agent后,学生可以自然地追问“缓存都在,为什么撤回还可能没用上”,再返回检查它究竟属于输入、计算还是事实使用层。
来源:原R7.1第七章、S36–S41扩展、LAB03 G;当前计算入口为T50–T51;本节记录为教学构造,编码/位置/cache为DN2 CPU真实机制验证;计时为DN1原云端记录;自然问答与bit任务能力评测未执行。
<span id="cache-and-effective-context-s07"></span>
## 复核与实现
返回LAB03的“路径C · 材料放得下,不代表采用了当前事实”,核对原文、字符ID、移动记录与过期cache负对照。
```python
def path_c():
text=document();moved=document([4,0,1,2,3]);vocab=sorted(set(text+'绿'));ids={c:i for i,c in enumerate(vocab)}
encode=lambda s:[ids[c] for c in s]
tokens=encode(text);model=old.TinyDecoder(seed=20261021,vocab=len(vocab));split=text.index('\n问题:')
full,_=model.full(tokens);_,cache=model.full(tokens[:split]);errors=[]
for t in range(split,len(tokens)):
actual,cache=model.incremental(tokens[t],cache,t);errors.append(float(np.max(abs(actual-full[t]))))
changed=text.replace('蓝柜','绿柜',1);changed_tokens=encode(changed)
_,oldcache=model.full(tokens[:-1]);stale,_=model.incremental(changed_tokens[-1],oldcache,len(tokens)-1)
fresh,_=model.full(changed_tokens);delta=float(np.max(abs(stale-fresh[-1])))
assert max(errors)<1e-10 and delta>1e-10
def spans(s):
return [{'event':t,'start_zero_based':re.search(r'(?m)^'+re.escape(t)+' ',s).start(),'end_exclusive':re.search(r'(?m)^'+re.escape(t)+' ',s).start()+len(t+' '+body)} for t,body in DOCUMENT_RECORDS]
return {'identity':'DN2 untrained TinyDecoder mechanism on explicit teaching character encoding, NOT document QA',
'document':text,'moved_document':moved,'question':QUESTION,'human_rule_answer':'蓝柜',
'encoding':'one Unicode code point -> one sorted-vocabulary ID; whitespace/newline/punctuation count; no BOS/template added',
'vocab':vocab,'token_ids':tokens,'token_count':len(tokens),'vocab_size':len(vocab),'prefill_tokens':split,
'spans':spans(text),'moved_spans':spans(moved),'moved_token_count':len(encode(moved)),
'full_incremental_max_error':max(errors),'changed_prefix_stale_cache_max_error':delta,
'cached_bytes':int(sum(c['K'].nbytes+c['V'].nbytes for c in cache)),
'model':{'layers':2,'heads':2,'width':8,'dtype':'float64','trained':False,'seed':20261021},
'task_prediction':'not evaluated; human answer is not a model prediction'}
```
<span id="cache-and-effective-context-s08"></span>
## 相邻知识与复核资源
[路径 B:换图后分布变了,模型是否看懂了](https://codingai-lec05.pages.dev/course/knowledge/visual-condition-use.html) · [给长前缀列一张有单位的资源账本](https://codingai-lec05.pages.dev/course/knowledge/resource-ledger.html)
[全部主题](https://codingai-lec05.pages.dev/course/knowledge/index.html) · [关键结果JSON](https://codingai-lec05.pages.dev/course/knowledge/data/learning-paths.json) · [只读诊断源码](https://codingai-lec05.pages.dev/course/knowledge/code/learning_paths.py.read.html) · [Seq2Seq完整实现](https://codingai-lec05.pages.dev/course/knowledge/code/seq2seq.py.read.html) · [视觉机制实现](https://codingai-lec05.pages.dev/course/knowledge/code/mechanisms.py.read.html) · [TinyDecoder与cache实现](https://codingai-lec05.pages.dev/course/knowledge/code/legacy_numpy.py.read.html)